소나기
미국 웨스트버지니아의 그린뱅크 전파망원경에서 수집된 실제 잡음 위에, 가짜 신호 15,000개가 차례로 부어졌다. 신호의 모양은 열 가지, 세기는 다섯 단계. 목적은 하나였다. 이미 학습이 끝난 인공지능 탐지기가, 자기가 배운 적 없는 신호를 만났을 때 무엇을 하는지 보는 것. 논문의 저자는 모델을 단 한 번 학습시키고 그 뒤로는 가중치를 전혀 건드리지 않았다. 냉동시킨 탐지기에 주사를 놓은 셈이다.
결과는 예상과 달랐다. 더 밝고 더 뚜렷한 신호를 넣을수록 탐지율은 오히려 떨어졌다. 논문은 이 현상을 이론의 문제가 아니라 측정의 문제로 제시한다. 그리고 그 원인을 아주 구체적인 한 줄로 지목한다. 이 탐지기는 관측 데이터의 절반만 읽고 있다.
실험의 설계 — 학습은 한 번, 시험은 15,000번
외계 문명의 전파를 찾는 테크노시그니처 탐색에서 인공지능은 후보 목록을 사람이 볼 수 있는 크기로 줄이는 역할을 맡는다. 문제는 그 탐지기들이 늘 학습 데이터와 같은 분포의 검증 데이터로 평가된다는 점이다. 그 분포에는 탐지기가 가장 실패하기 쉬운 경우가 빠져 있다. 진짜 테크노시그니처의 모양은 아무도 모르고, 지구 간섭의 다양성에는 끝이 없다.
그래서 이 논문은 검증 대신 주입 실험을 택했다. 실제 그린뱅크 배경 잡음에 인공 신호를 심고, 그 신호를 탐지기가 찾아내는지 세었다. 조건은 두 갈래였다. 하나는 훈련 데이터의 직선 좁은 대역선과 다른 모양의 진짜 신호들, 다른 하나는 훈련 데이터와 닮은 꼴의 간섭이다. 전자는 놓치면 안 되는 것, 후자는 걸러야 하는 것이다.
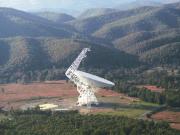
그린뱅크 전파망원경(GBT). 웨스트버지니아 알러게니 산맥 계곡에 있으며, 2.3에이커의 전파를 모은다 — NRAO/AUI, CC BY 3.0 (Wikimedia Commons)
반직관적 결과 — 밝아질수록 놓친다
상식적으로 신호가 세지면 찾기 쉬워져야 한다. 신호 대 잡음비가 올라가니까. 그런데 재현율은 그 순서를 따르지 않았다. 신호를 밝게 만들수록 오히려 떨어졌고, 심지어 탐지기가 학습한 바로 그 종류의 직선 신호에서도 0.590에서 0.090까지 내려갔다. 열 번 중 아홉 번을 놓친다는 뜻이다.
이 숫자가 중요한 이유는 그것이 '어려운 신호'의 이야기가 아니라는 점이다. 가장 자신 있게 배운 모양에서, 더 좋은 조건으로, 더 많이 실패했다. 저자는 이 역전을 놓친 신호 계열의 성질로 설명한다. 신호가 강해질수록 탐지기가 학습한 특징 공간에서 오히려 '학습 데이터답지 않은' 쪽으로 밀려난다는 것이다.
0.627이라는 숫자 — 간섭이 진짜 신호보다 잘 통과한다
반대 방향의 실패도 측정됐다. 어떤 간섭 모양 하나는 오탐률 0.627을 기록했다. 같은 탐지기가 진짜 신호에서 보인 기준 재현율 0.5525보다 높다. 즉 이 탐지기는 진짜를 찾아내는 능력보다, 가짜를 진짜라고 우기는 능력이 더 뛰어난 상태였다.
논문은 이 대비를 강조한다. 탐지기의 성능표에는 재현율과 오탐률이 나란히 적히지만, 실제 운영에서는 두 숫자가 완전히 다른 결과를 낳는다. 놓친 신호는 다음 관측에서 다시 올 기회가 있지만, 오탐은 사람의 관측 시간을 태우고 후보 목록을 오염시킨다. 그 모양의 간섭은 열 번 중 여섯 번 이상이 진짜 후보로 분류된다는 뜻이다.
이유는 ON 패널만 읽기 때문이다
테크노시그니처 관측의 기본 논리는 ON-OFF 비교다. 망원경을 목표 별에 향한 채 찍은 것이 ON, 살짝 비켜서 찍은 것이 OFF다. 별에서 오는 신호는 ON에만 나타나고, 지구 간섭은 두 패널 모두에 나타난다. 진짜 후보와 지구 간섭을 구분하는 유일한 증거가 바로 버려지는 쪽에 있다.
그런데 이 탐지기는 ON 패널만 입력으로 받는다. 그래서 저자의 결론은 날카롭다. 이 모델은 신호가 목표 별에서 왔는지 판정할 수 없다. 오직 학습 데이터와 닮았는지만 판정한다. 오탐이 발생하는 직접적 이유가 여기에 있다.
Grad-CAM으로 들여다본 결과도 같은 방향을 가리킨다. 놓친 계열 하나에서는 사전에 정한 검정 방식으로 주입 경로에 주의가 향한 것이 확인됐고, 다른 계열에서는 시각적으로 확인됐다. 모델이 신호를 못 본 것이 아니라, 신호의 다른 부분을 보고 있었다.
1977년 8월 빅이어 전파망원경이 받은 이른바 'Wow!' 신호의 원본 프린트아웃. 72초간 관측됐고 이후 재현되지 않았다 — Big Ear Radio Observatory / NAAPO, Public domain (Wikimedia Commons)
경쟁 가설, 그리고 반론
가장 먼저 나올 반론은 '데이터가 부족했다'이다. 더 다양한 모양으로 더 많이 학습시키면 해결된다는 주장이다. 논문은 이 반론을 완전히 배제하지 않는다. 다만 학습 분포를 넓히는 일은 끝이 없는 작업이며, 간섭의 다양성이 무한하다는 점을 감안하면 분포 확장만으로는 오탐 0.627을 설명하지 못한다고 본다.
두 번째 반론은 'ON-OFF 필터를 붙이면 된다'이다. 실제로 논문은 사전에 정한, 시간 평균을 취한 ON-OFF 필터를 시험했다. 결과는 필터가 오탐과 진짜 탐지를 같은 비율로 제거했다는 것이다. 필터를 붙이면 오탐이 줄어드는 대신 진짜 후보도 같은만큼 사라진다. 탐지기가 애초에 구분에 필요한 정보를 받지 못했기 때문에, 사후에 붙인 필터가 그 정보를 만들어낼 수는 없다.
세 번째 반론은 '그럼 OFF 패널도 입력으로 넣으면 되지 않나'이다. 저자는 이 지점에서 스스로 선을 긋는다. OFF 패널을 읽는 것만으로는 놓친 신호가 되살아나지 않는다는 것이다. 놓친 신호는 탐지기가 무엇을 '인식하도록' 배웠는지의 문제이지, 어떤 패널을 읽었는지의 문제가 아니다. 두 실패는 원인이 다르다.
저자가 인정한 한계
논문은 이 결과를 모든 테크노시그니처 탐지기에 일반화하지 않는다. 실험은 하나의 표준 경쟁용 탐지기를 학습시켜 얼린 단일 사례이고, 주입도 열 가지 모양과 다섯 단계 세기라는 유한한 격자 위에서 이뤄졌다. 실제 관측에서 마주칠 모양이 이 격자 안에 있다는 보장은 없다.
또한 저자는 놓친 신호의 원인을 완전히 규명했다고 주장하지 않는다. Grad-CAM은 모델이 어디를 보는지 보여주는 근사일 뿐, 왜 그렇게 배웠는지를 설명하지는 않는다. 오탐 쪽은 ON 패널만 읽는다는 구조적 사실로 직접 설명되지만, 놓침 쪽은 '무엇을 인식하도록 배웠는가'라는 더 흐릿한 설명에 머문다. 이 비대칭을 저자 스스로 명시한다.
그래서 무엇이 남는가
이 논문이 남기는 것은 모델 하나의 성적표가 아니라 평가 방식에 대한 질문이다. 학습 분포 안에서 잘 맞히는 능력은, 분포 밖에서 무엇을 놓치는지에 대해 아무것도 말해주지 않는다. 0.5525라는 기준 재현율은 검증 데이터에서 나온 숫자이고, 0.627은 실제 배경 잡음 위에서 나온 숫자다. 두 숫자 사이의 간격이 이 논문의 실체다.
더 불편한 함의도 있다. 자동화된 탐지기가 후보를 줄여줄수록, 사람은 그 목록을 더 신뢰하게 된다. 그런데 그 목록의 절반이 간섭이고, 진짜 신호는 밝을수록 더 자주 사라진다면, 자동화는 탐색의 속도를 높이는 대신 탐색의 방향을 조용히 바꿔놓는다. 논문은 이 방향 전환이 측정 가능하다는 것을 보여준다.
여러분이라면 어느 쪽을 의심하겠는가. 밝은데 놓친 신호인가, 어두운데 잡힌 신호인가. 아니면 애초에 그 탐지기가 무엇을 보고 있는지부터 확인하겠는가.
참고 자료
Omer Imran, 'Missed Detections and False Alarms in a CNN Technosignature Detector on Breakthrough Listen Data', arXiv:2610.22050v2 (2026-10-15).
https://arxiv.org/abs/2610.22050v2
댓글2
모든 이야기1528
가벼운 안부부터 깊은 생각까지, 함께 나눠요.