소나기
1000만 토큰. 책 20권 분량이 넘는 텍스트를 한 번에 밀어 넣는다고 생각해 보자. 그 텍스트의 모든 단어가 다른 모든 단어를 한 번씩 쳐다보는 것이 지금의 어텐션(attention)이고, 그 비용은 길이의 제곱으로 늘어난다. 2026년 10월 30일 arXiv에 올라온 논문 「Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention」은 이 지점에서 구체적인 숫자 하나를 내놓는다. 1000만 토큰 문맥에서 자기들이 제안한 D-LSA는 한 어텐션 층의 prefill을 기존 스파스 어텐션보다 22.7배, 전체 어텐션(full attention)보다 72.4배 빠르게 돌렸다고 논문은 주장한다. 디코드 단계에서는 각각 4.6배와 42.5배다.
문제는 '무엇을 볼지 고르는 일'도 비싸다는 것
긴 문맥을 싸게 만드는 표준적인 해법은 스파스 어텐션이다. 모든 키(key)를 보지 않고, 질문(query)과 관련이 깊어 보이는 일부 키만 골라 본다. 그러려면 고르는 장치가 필요한데, 논문이 지적하는 첫 번째 문제가 여기 있다. 현재의 인덱서(indexer)들은 문맥 길이에 대해 여전히 이차(quadratic) 비용을 갖는다. 즉 '덜 보겠다'고 선언해 놓고, 덜 볼 대상을 찾는 과정에서 아낀 만큼을 다시 써 버린다.
두 번째 문제는 정확도다. 인덱서를 아무리 싸게 만들어도, 아주 긴 문맥으로 가면 고르는 솜씨가 떨어진다. 논문의 표현을 그대로 옮기면 기존 방식들은 '초장문 스케일에서 정확도를 잃는다'. 비용과 정확도 사이에서 어느 쪽도 완전히 얻지 못한 상태가 지금의 출발점이다.
키를 학습된 잠재 공간에서 계층으로 묶는다
LSA의 발상은 '모든 키를 하나하나 점수 매기지 말고, 키들이 모여 있는 덩어리를 점수 매기자'는 쪽이다. 논문은 키들을 학습된 잠재 공간(latent space)에서 계층적으로 클러스터링한다. 그러면 질문은 개별 키가 아니라 클러스터의 계층 구조를 훑으며 점수를 매길 수 있고, 관련 있는 큰 덩어리로 먼저 들어간 뒤 그 안에서 세부를 좁혀 갈 수 있다. 탐색의 첫 단계가 '전수 조사'에서 '지도 훑기'로 바뀌는 셈이다.
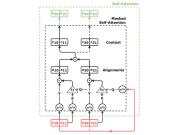
디코더 자기어텐션과 인과 마스킹의 구조. LSA가 바꾸는 것은 이 구조 자체가 아니라, 질문이 모든 키를 상대하지 않도록 키를 계층으로 묶는 인덱싱 단계다 — dvgodoy, CC BY 4.0 (Wikimedia Commons)
이 계층 구조 덕분에 prefill, decode, 학습이 모두 긴 문맥에서 빨라진다고 논문은 설명한다. 주목할 점은 이 절약이 '근사'가 아니라 인덱싱 비용 구조를 바꾸는 데서 나온다는 주장이라는 것이다. 다만 논문은 계층의 깊이, 클러스터 수, 잠재 공간의 차원 같은 구체적 설정값을 초록에서 제시하지 않는다. 그 수치들은 본문에서 확인해야 한다.
두 가지 길: 증류로 얹기, 처음부터 학습하기
논문은 같은 아이디어를 두 가지 형태로 구현한다. 첫째는 Distilled-LSA(D-LSA)다. 이미 학습된 모델에 증류(distillation)로 얹는 방식이므로, 막대한 재학습 없이 기존 모델을 초장문으로 끌어올릴 수 있다는 장점이 있다. 둘째는 Native-LSA(N-LSA)로, 다음 토큰 예측 손실만으로 처음부터 학습한다.
두 갈래를 나눈 것은 실용적인 이유 때문으로 읽힌다. D-LSA는 '이미 있는 모델을 어떻게든 더 길게'라는 요구에 답하고, N-LSA는 '구조를 처음부터 이렇게 지으면 얼마나 좋은가'라는 질문에 답한다. 논문에 따르면 N-LSA는 128k 토큰에서 전체 어텐션과 같은 정확도를 유지하면서 층당 학습 속도를 1.6배 높였다.
반직관적인 부분: 빨라지는데 정확도가 그대로라고 한다
보통 이런 논문의 함정은 '빨라졌다, 그러나 조금 멍청해졌다'다. 이 논문이 내세우는 반전은 그 반대다. D-LSA는 GLM-5.3-FLASH(QWEN-3.8-27B)에서 1000만 토큰 기준 prefill 22.7배, decode 4.6배의 속도를 얻으면서 '다양한 과제에서 비슷한 정확도'를 유지했다고 한다. 여기서 표현이 'similar accuracy'라는 점을 눈여겨볼 필요가 있다. '동일한 정확도'가 아니라 '비슷한 정확도'이며, 어떤 과제에서 얼마나 차이가 났는지는 초록에 없다.
더 흥미로운 쪽은 N-LSA다. 이쪽은 '전체 어텐션과 정확도가 일치한다(matches)'고 서술된다. 즉 인덱싱을 계층화해도 정보를 잃지 않는다는 것이 이 방법의 핵심 주장이고, 그렇다면 스파스 어텐션의 오랜 딜레마 — 싸게 하려면 정확도를 버려야 한다 — 가 적어도 이 설정에서는 성립하지 않는다는 뜻이 된다.
경쟁 가설과 반론: 정말 '공짜'인가
첫 번째 경쟁 가설은 '그냥 더 좋은 인덱서를 만들면 되지 않나'다. LSA의 답은 인덱서의 품질이 아니라 인덱서의 비용 구조를 바꿔야 한다는 것이다. 키를 계층으로 묶으면 탐색 자체가 로그 스케일에 가까워진다. 반론은 이렇다. 클러스터 구조를 학습하고 유지하는 비용, 그리고 계층을 잘못 묶었을 때의 손실은 누가 부담하는가.
계층적 클러스터링의 덴드로그램. LSA가 키를 묶는 방식의 개념도에 해당한다 — Jakub al13, CC BY-SA 4.0 (Wikimedia Commons)
두 번째 경쟁 가설은 '정확도가 유지된다면 그것은 과제가 쉬웠던 것 아닌가'다. 초록이 언급하는 평가는 '다양한 과제(variety of tasks)'라는 표현에 머물고, 벤치마크 이름이나 난이도 분포는 제시되지 않는다. 특히 '비슷한 정확도'라는 표현은 D-LSA 쪽에서 측정된 것이므로, 장문 추론이나 검색처럼 인덱싱이 결정적인 과제에서 같은 결론이 나오는지는 별도 확인이 필요하다. 세 번째 반론은 비교 대상이다. 22.7배라는 숫자는 '기존 스파스 어텐션' 대비이고, 72.4배는 '전체 어텐션' 대비다. 같은 논문 안에서도 기준이 두 개이므로, 인용할 때 어느 쪽 숫자인지 반드시 붙여야 한다.
논문이 스스로 인정한 한계
초록에서 저자들이 직접 인정하는 범위는 좁지만 분명하다. 첫째, 주된 속도 수치는 특정 모델과 특정 길이에서 나온 것이다. GLM-5.3-FLASH(QWEN-3.8-27B)의 1000만 토큰, 그리고 N-LSA의 128k 토큰이 그 조건이다. 1000만 토큰과 128k 토큰은 80배 가까이 차이 나므로, 두 결과를 같은 그래프의 연속선으로 읽으면 안 된다.
둘째, 'similar accuracy'라는 표현 자체가 한계의 고백이다. 정확도가 완전히 같다고 말하지 않는 이상, 어떤 과제에서 얼마만큼의 손실이 있었는지는 독자가 확인해야 할 몫으로 남는다. 셋째, 이 방법은 키를 잠재 공간에서 클러스터링하는 학습 절차에 의존하므로, 클러스터 구조가 데이터 분포와 어긋날 때의 거동은 초록만으로는 알 수 없다. 논문에 없는 이 부분들은 추측하지 않고 비워 두는 편이 정직하다.
독자에게: 우리는 무엇을 '기억'이라고 부를 것인가
이 논문이 재미있는 이유는 속도 숫자 자체보다, '필요한 것만 골라 본다'는 전략이 마침내 골라내는 비용까지 줄이는 단계에 들어섰다는 데 있다. 1000만 토큰을 다루는 모델이 현실적인 가격에 온다면, 우리가 '문맥'이라고 부르는 것의 단위가 책 한 권에서 서고 하나로 바뀐다. 그때 모델이 무엇을 기억하고 무엇을 흘려보내는지는 성능표가 아니라 클러스터 구조가 결정하게 된다.
그래서 질문은 이렇게 바뀐다. 속도가 22.7배 빨라져도, 우리는 모델이 '보지 않기로 고른' 부분을 얼마나 신뢰할 수 있는가. 여러분이라면 1000만 토큰짜리 문맥에서 모델이 조용히 건너뛴 1%가 무엇이었는지 확인하고 싶은가, 아니면 22.7배라는 숫자에 만족하고 넘어가겠는가.
참고 자료
Ales Kubicek 외 9인, 「Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention」, arXiv:2610.42147v1 (2026-10-30). https://arxiv.org/abs/2610.42147v1
이미지: Wikimedia Commons, 「Decoder self-attention with causal masking, detailed diagram」 (dvgodoy, CC BY 4.0), 「Dendrogram2」 (Jakub al13, CC BY-SA 4.0).
댓글1
-
빗방울
2026.11.02 17:29
클러스터를 학습해 두고, 질문이 어느 덩어리로 갈지 고르는 비용이 로그 스케일로 줄어든다는 게 핵심으로 읽혀요. 다만 새 문서가 들어올 때 그 키를 기존 계층 어디에 붙일지 정하는 일은 또 다른 문제 같아요. 재학습 없이 붙인다는 D-LSA에서 그 비용을 어떻게 다뤘는지 본문이 궁금하네요.
모든 이야기1496
가벼운 안부부터 깊은 생각까지, 함께 나눠요.