소나기
미국 퍼듀 대학의 1학기 미적분 기반 물리학 실험 수업. 14개 팀이 각자 다른 문제를 들고 나왔다. 야구공의 홈런 조건, 장난감 투석기의 사거리, 포뮬러 1 자동차의 코너링 속도, 번지점프에 안전한 최대 질량, 방탄조끼가 총알을 3.8cm 안에 멈추게 하려면 필요한 힘. 학기 말 성적이 나왔고, 수업 평균은 78%였다. 연구진은 이 평균에서 표준편차 한 개(±10%)를 기준으로 팀을 고성취·중성취·저성취로 갈랐다. 그리고 각 팀이 제출한 '전산 물리 설계 에세이'(CPDE)를 문장 단위로 뜯어보기 시작했다. 묻는 것은 하나였다. 좋은 성적을 받은 팀이 실제로 더 깊이 생각했는가.
78%와 ±10%: 팀을 가른 기준
이 논문이 다루는 수업은 흔한 '예비 보고서' 수업이 아니다. 학생들은 14번의 수업에 걸쳐 하나의 설계 문제를 반복해서 고친다. 문제 진술을 다듬고, 초기 해법과 그 한계를 적고, 첫 번째 반복 계산을 하고, 선택적으로 두 번째 반복을 한다. 최종 산출물인 CPDE에는 이 전 과정이 남는다. 결과만 남는 시험지와 달리, 어디서 막혔고 무엇을 고쳤는지가 문서에 그대로 드러난다.
팀 분류는 팀원들의 기말고사 점수 평균으로 이뤄졌다. 고성취 팀은 T01·T04·T05·T12, 중성취 팀은 T03·T07·T09·T11·T14, 저성취 팀은 T02·T06·T08·T10·T13이다. 표 III을 보면 팀 평균이 92.33%인 T01부터 70.00%인 T10까지 흩어져 있다. 연구진은 이 분류를 '능력의 대리 지표'로 쓰되, 뒤에서 여러 번 이 지표의 한계를 스스로 지적한다.
다섯 가지 사고방식, 세 단계 잣대
분석 틀은 WoT4EDP다. 과학 기반 사고(SBT), 설계 기반 사고(DBT), 수학 기반 사고(MBT), 전산 사고(CT), 메타인지 성찰(MER)의 다섯 갈래를 세운다. 핵심은 각 갈래가 '있는가'가 아니라, 두 갈래가 한 문장이나 한 문단 안에서 어떻게 이어지는가다. 예컨대 스프링 상수를 언급하면서 그 값을 구하는 것이 너무 복잡하다고 판단하면 수학과 성찰이 만난 것이고, 설계 제약을 물리 법칙으로 정당화하면 과학과 설계가 만난 것이다.
연구진은 이 연결을 세 단계로 나누는 루브릭을 만들었다. 1단계 얕음(superficial)은 두 사고가 나란히 언급되지만 이유 설명이 없는 경우, 2단계 중간(intermediate)은 근거나 부분적 정당화가 붙은 경우, 3단계 실질(substantial)은 명시적 추론과 정당화로 두 사고가 실제로 맞물린 경우다. 세 명의 평가자가 3개 팀의 에세이에 먼저 독립적으로 적용한 뒤 합의를 거쳐 기준을 다듬었고, 그 기준을 14개 팀 전체에 적용했다. 24쪽, 그림 20개, 표 8개짜리 분석이다.
세 팀의 문제 진술: 야구공, 장난감 투석기, 방탄조끼
본문에서 가장 흥미로운 대목은 같은 '문제 진술' 항목에서 세 팀이 전혀 다른 깊이를 보인다는 점이다. 고성취 팀 T01은 MLB의 홈런 확률 12.10%를 인용하며 시작하지만, 투구 속도와 회전량을 계산해 궤적을 예측하겠다는 선언에 머문다. 설계 제약이나 사용자 조건은 등장하지 않는다. 반면 중성취 팀 T09는 '던컨의 장난감 상자'라는 가상 고객을 세우고, 플라스틱과 폼 소재, 덮인 스프링, 실내외 사용 안전성까지 제약으로 명시한다. 과학 원리가 설계 조건과 직접 연결된 3단계 사고다.
저성취 팀 T10은 더 노골적이다. 1500년대 방탄조끼 역사로 시작해, 0.0075kg 총알이 1320km/h로 날아와 0.00073초 동안 이동한 뒤 3.8cm 안에서 멈춘다는 조건을 문제 안에 그대로 박아 넣는다. 연구진은 이 팀의 수학-설계 연결을 3단계로 평가한다. 숫자가 계산 결과로 붙는 것이 아니라, 설계의 해 공간 자체를 규정하는 제약으로 들어왔기 때문이다.
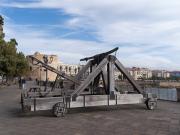
사르데냐 알게로 해안에 세워진 재현 목제 투석기. T09 팀이 설계한 장난감 투석기와 T04 팀이 다룬 투석기의 원형에 해당하는 장치다 — Alexkom000, CC BY 4.0 (Wikimedia Commons)
반전: 시험 성적과 통합적 사고는 비례하지 않는다
전체 연결 빈도의 평균은 고성취 60회, 저성취 52회, 중성취 36회다. 고성취가 1위인 것은 맞지만, 2위가 저성취라는 점이 이 논문의 첫 번째 반전이다. 게다가 깊이를 따로 떼어보면 순서가 더 흐트러진다. 3단계 실질 연결의 팀 평균은 고성취 27회, 저성취 28회, 중성취 18회다. 표 VIII과 표 VI를 나란히 놓으면 고성취와 저성취가 사실상 동률이고, 중성취만 뚜렷하게 낮다.
저자들이 내놓는 해석은 이렇다. 기말고사는 개인의 개념 이해와 정답 도출을 재지만, CPDE는 다섯 갈래 사고를 동시에 조율하며 열린 해를 평가하는 일을 요구한다. 그래서 시험을 잘 보는 능력과 설계 문서에서 사고를 엮어내는 능력이 같은 것을 재지 않을 수 있다는 것이다. 물리교육 연구에서 정량적 문제풀이 성적이 개념 이해를 대변하지 못한다는 오랜 관찰과 같은 맥락이다.
더 강한 반전: 성찰에서는 저성취 팀이 앞섰다
가장 눈에 띄는 뒤집힘은 과학-성찰(SBT–MER) 연결에서 나온다. 저성취 팀은 실질 4회, 중간 2회, 얕음 1회로 깊은 쪽에 몰려 있다. 반대로 고성취 팀은 얕음 4회, 중간 2회, 실질 1회로 정확히 반대 분포다. 고성취 팀이 성찰을 더 자주, 더 깊게 했다는 통념이 이 14개 팀에서는 성립하지 않는다.
수학-성찰(MBT–MER)도 비슷하다. 저성취 팀은 실질 1·중간 1·얕음 3, 중성취 팀은 실질 0·중간 2·얕음 2, 고성취 팀은 실질 1·중간 1·얕음 4다. 세 집단 모두 얕은 쪽으로 기울지만, 기울기의 모양이 다르다. 저자들은 성찰의 정교함이 전체 성적과 함께 단조롭게 올라가지 않는다고 적는다. 성찰은 성적의 함수가 아니라, 무엇에 성찰을 연결하느냐의 문제일 수 있다는 뜻이다.
경쟁 가설과 반론: 전산 사고는 왜 드물게, 그러나 깊게 나타났나
이 결과를 설명할 경쟁 가설은 여럿이다. 첫째, 표본이 작다. 14개 팀, 한 과목, 한 기관, 한 실험 분과다. 저자들 스스로 이 차이를 '통계적으로 유의한 차이의 증거로 읽지 말라'고 못 박는다. 둘째, 보고서 길이 효과다. 긴 보고서는 사고를 드러낼 기회가 많고, 짧은 보고서는 실제로 같은 수준으로 생각했어도 코드가 덜 붙는다. 셋째, 팀 단위 분석이라는 점이다. 한 학생이 연결을 독점했을 수 있어 개인 성적과 팀 사고를 직접 잇기 어렵다.
흥미로운 반례 하나가 이 '길이 효과' 가설을 부분적으로 흔든다. 전산 사고(CT)가 들어간 연결을 보면, 설계-전산(DBT–CT)은 세 집단 모두 평균 1회뿐이고 전산-성찰(CT–MER)도 고성취 2회, 나머지 1회 수준이다. 그런데 과학-전산(SBT–CT)과 수학-전산(MBT–CT)은 빈도가 낮아도, 나타날 때는 대부분 3단계 실질 연결이었다. 즉 전산 사고는 문서 전체에 얇게 깔리지 않았고, 특정 지점에서 한 번 깊게 등장했다. 저자들이 끌어내는 교육적 결론도 여기에 맞닿아 있다. 계산을 더 시키는 것이 아니라, 계산 결과가 어떤 설계 결정을 바꾸는지 명시적으로 쓰게 하라는 것이다.
이 수업의 설계·계산은 주피터 노트북에서 이뤄진다. 전산 사고 연결이 문서 전체에 고르게 퍼지지 않고 특정 지점에 몰린 이유를 보여주는 맥락이다 — Andrey Yakimchik, CC BY 4.0 (Wikimedia Commons)
논문이 스스로 인정한 한계
한계 절은 네 가지를 든다. 단일 과목·단일 기관·단일 분반이라 일반화가 제한된다는 점, 분석 자료가 최종 문서뿐이라 사고 과정 자체를 포착하지 못한다는 점, 보고서 길이와 역할 분담의 변동이 관찰되는 연결 수를 좌우한다는 점, 그리고 기말 성적 기반 분류가 창의성·협업·개념 이해를 담지 못한다는 점이다. 특히 두 번째 한계는 뼈아프다. 학생이 의도적으로 어떤 사고를 강조하고 다른 사고를 생략했다면, 문서에 없는 사고는 코드되지 않는다.
여기에 필자가 표를 읽으며 확인한 지점을 하나 덧붙인다. 방법 절은 고성취를 '수업 평균 78%에서 표준편차 한 개(+10%) 위', 저성취를 '그 아래(-10%)'로 정의한다. 그런데 표 III의 팀 평균을 보면 76.67%인 T02, 74.33%인 T08, 73.33%인 T13이 모두 저성취로 분류된다. 70.2%와 85.8% 사이의 중간 구간에 들어가는 값들이다. 팀 분류가 팀 평균만이 아니라 팀원 개별 점수의 분포까지 반영한 결과로 보이지만, 논문은 그 절차를 명시하지 않는다. 저자들이 명시한 한계는 아니지만, 집단 분류가 얼마나 견고한지 판단할 때 감안해야 할 부분이다. 마찬가지로 결과 절은 실질 연결을 '평균 26회'로, 논의 절과 표는 27~28회로 적어 수치가 완전히 일치하지 않는다. 큰 결론을 뒤집는 차이는 아니지만, 세부 수치를 인용할 때는 표를 기준으로 삼는 편이 안전하다.
독자에게 던지는 질문, 그리고 참고 자료
이 논문이 실제로 증명한 것은 '저성취 학생도 통합적으로 사고할 수 있다'는 가능성의 존재이지, '성적과 사고력이 무관하다'는 명제가 아니다. 14개 팀의 서술 통계이고, 저자들도 인과를 주장하지 않는다. 그런데도 남는 질문이 있다. 우리가 성적이라는 숫자로 재고 있는 것은 무엇이며, 그 숫자에서 빠진 것은 무엇인가. 그리고 성찰을 많이 하게 만드는 것과, 성찰을 계산·설계와 연결하게 만드는 것 중 어느 쪽이 교육적으로 더 어려운 일인가.
논문은 후속 연구로 LLM을 평가자로 쓰는 방향을 예고한다. 전문가 코딩과 비교해, 다섯 갈래 사고의 연결을 자동으로 분류할 수 있는지 확인하겠다는 계획이다. 사람이 24쪽짜리 보고서를 문장 단위로 코딩하는 작업을 모델이 대신할 수 있다면, 표본 14개라는 이 연구의 가장 큰 약점도 다음 연구에서 해소될 수 있다. 다만 그때도 남는 질문은 같을 것이다. 연결의 빈도가 아니라 깊이를 어떻게 안정적으로 읽어낼 것인가.
참고 자료: Babu, Chatta Subramaniam, Rebello, Morphew, Rebello, "Integrative Thinking in Computational Physics Design Essays", arXiv:2610.22154v1 [physics.ed-ph], 2026-10-15. https://arxiv.org/abs/2610.22154v1
댓글2
-
빗방울
2026.11.03 11:45
중성취 팀만 유독 실질 연결이 낮았던 게 걸립니다. 고성취 27, 저성취 28, 중성취 18이면 성적과 단조 관계가 아니라 가운데가 꺼진 모양이거든요. 팀 표본이 4~5개뿐이라 우연일 수도 있겠지만, 반대로 말하면 이 14개 팀으로는 성적-사고력 관계를 아예 말하기 어렵다는 뜻이기도 합니다. -
빗방울
2026.11.03 12:13
주피터 노트북 얘기 나와서 ㅋㅋ 계산 돌려놓고 결과만 캡처해서 붙이는 팀 많을 듯. 근데 이 논문은 계산이 어떤 설계 결정을 바꿨는지 쓰라는 쪽이네 ㄷㄷ 그 한 줄이 없는 보고서는 코드 넣어도 1단계에 머문다는 거잖아
모든 이야기1622
가벼운 안부부터 깊은 생각까지, 함께 나눠요.
총 1622개의 이야기