소나기
2026년 11월 2일, arXiv에 한 편의 실험 보고서가 올라왔다. 저자는 Kara D. Lamb 한 사람이다. 논문이 남긴 숫자 하나가 눈에 걸린다. 감독 없이(unattended) 언어모델 에이전트들이 만들어낸 100개의 물리 코드 중 정확히 2개가, 사람이 정성껏 다시 조율한 가장 정확한 기존 물리 방안보다 살짝 더 낮은 강수 질량 오차를 보였다. 100개 중 2개. 성공률 2퍼센트다. 그런데 이 논문의 결론은 'AI는 아직 못한다'가 아니다. 오히려 그 반대에 가깝다. 이 2퍼센트가 무엇을 의미하는지가 이 논문의 진짜 논점이다.
따뜻한 비는 왜 아직도 숙제인가
지구시스템 모델(ESM)은 격자 크기보다 작아서 직접 계산할 수 없는 과정을 '매개변수화(parameterization)'로 대신한다. 대류, 구름 미세물리, 난류가 대표적이다. 논문이 든 예시 그대로, 물리학적 이해가 진전되어도 그것을 안정적이고 검증된 매개변수화로 바꾸고 모델에 통합하는 데는 흔히 수년이 걸린다. 이해와 코드 사이의 이 지연이 논문이 겨냥하는 지점이다.
시험대는 '따뜻한 비(warm rain)'의 충돌·병합 과정이다. 얼음상이 개입하지 않는, 물방울끼리 부딪쳐 커지는 구간이다. 구름물리에서 가장 오래된 주제 중 하나이면서도, 벌크(bulk) 매개변수화로 옮기는 순간 입자 크기 분포를 몇 개의 모멘트로 접어야 하는 근본적 손실이 생긴다. 논문은 바로 이 지점에서 에이전트가 무엇을 할 수 있는지 시험한다.
실험 설계: 문헌 종합에서 미분 가능한 JAX 코드까지
에이전트에게 요구한 일은 세 가지다. 첫째, 과학 문헌을 종합할 것. 둘째, 이미 발표된 벌크 매개변수화를 재구현할 것. 셋째, 새로운 함수형(functional form)을 제안하고 그것을 미분 가능한 JAX 코드로 쓸 것. 결과물이 단순히 돌아가는 코드가 아니라 미분 가능하고 질량을 보존하는 코드여야 한다는 조건이 붙는다. 매개변수화를 코드로 옮기는 일은 논문에서 '수년'이라고 표현된 그 작업이다.
비교 대상은 세 갈래다. 전통적 매개변수화, 데이터로 학습한 에뮬레이터, 그리고 에이전트가 생성한 닫힘항(closure). 이 셋을 고해상도 슈퍼도플릿(superdroplet) 시뮬레이션에 견준다. 실험은 언어모델 10종에 걸쳐, 사람이 개입하지 않는 방식으로 반복되었다. 즉 이 논문은 한 모델의 데모가 아니라 모델 10종 × 방안 여러 개 × 반복이라는 격자 위의 결과다.
여기서 방법론의 핵심은 '무엇을 정답으로 두는가'다. 매개변수화끼리 비교하면 누가 더 나은지 알 수 없다. 논문은 슈퍼도플릿 시뮬레이션을 기준으로 세운다. 각각의 물방울을 라그랑주 입자로 들고 가며 충돌·병합을 직접 세는 방식이고, 그 대가로 계산 비용이 크다. 비용이 크기 때문에 실전 모델에는 못 쓰지만, 벌크 방안이 얼마나 틀렸는지 재는 자로는 쓸 수 있다.
평가 지표로 논문이 명시한 것은 롤아웃 오차(rollout error)와 강수 질량 오차다. 요약에서 강조되는 결론도 이 두 지표 위에 서 있다. 주목할 점은 '학습된 방안'과 '다시 조율한 물리 방안'을 같은 자로 재었다는 것이다. 이 비교가 없었다면 2/100이라는 숫자는 나오지 않았을 것이다.
반전 하나: 피드백이 열 개 중 여덟 개를 고쳤다
논문은 감독 없는 실행의 성능이 '방안과 언어모델에 크게 의존했다'고 적는다. 이건 실패담처럼 읽히지만, 동시에 조건이 무엇인지를 말해준다. 전문가의 안내나 반복적 피드백이 있으면 에이전트는 실행 가능하고, 미분 가능하고, 질량을 보존하는 코드를 만들어냈다. 핵심은 코드를 쓰는 능력이 아니라 틀린 것을 보고 고치는 루프가 성능을 좌우한다는 점이다.
그 루프의 효과는 숫자로 나온다. 반복 피드백은 10개 모델 중 8개에서 롤아웃 오차의 중앙값을 낮췄다. 열 개 중 여덟, 즉 두 개는 개선되지 않았다. 논문은 그 두 개가 왜 남았는지, 어떤 방안에서 특히 잘 듣는지를 함께 보고한다. 요약만으로는 그 세부를 알 수 없지만, 적어도 '피드백을 주면 다 된다'는 식의 낙관은 이 논문의 데이터가 지지하지 않는다.
반전 둘: 값싼 물리가 학습 모델을 이겼고, 100개 중 2개는 그마저 이겼다
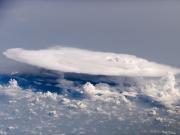
아프리카 상공의 적란운. 위성에서 본 넓은 판 모양의 꼭대기는 상승 기류가 멈춘 높이를 보여준다. — NASA/ISS 16, 퍼블릭 도메인 (Wikimedia Commons)
두 번째 반전은 더 흥미롭다. 다시 조율한(retuned) 물리 방안들이 훨씬 낮은 계산 비용으로 많은 학습 기반 매개변수화와 대등하거나 능가했다. 요약의 표현 그대로다. 신경망 에뮬레이터가 전통 물리를 대체할 것이라는 기대와 정면으로 부딪히는 결과다.
이 결과를 곱씹어야 하는 이유는, 여기서 '조율'을 누가 했는지가 흐려지기 때문이다. 논문은 이 재조율이 사람에 의한 것인지 에이전트 루프에 의한 것인지를 요약에서 명확히 구분하지 않는다. 다만 분명한 것은, 함수형을 새로 발명하는 일보다 기존 함수형의 계수를 다시 맞추는 일이 주어진 예산 안에서 더 나은 수익을 냈다는 사실이다.
그리고 여기가 이 논문을 정말 흥미롭게 만드는 지점이다. 감독 없는 실행에서 나온 100개의 닫힘항 가운데 2개가, 홀드아웃 시뮬레이션에서 가장 정확한 재조율 방안보다 약간 더 낮은 강수 질량 오차를 기록했다. 2퍼센트. 무시할 수 있는 수치일까.
해석은 갈린다. 하나는 '탐색 비용이 거의 0에 가까운 탐색'이라는 읽기다. 100번을 던져 2번 건지는 방식은 사람이 100개의 함수형을 고안해 비교하는 것보다 훨씬 싸다. 다른 하나는 '선택 효과'라는 읽기다. 100개를 던지고 그중 잘 나온 것을 골랐다면, 그 2개가 홀드아웃에서도 이겼다는 사실은 단순한 우연 이상이지만, 동시에 98개를 버린 뒤의 이야기이기도 하다. 논문은 이 2개가 어떤 함수형이었는지, 왜 통했는지를 요약에서 밝히지 않는다. 그 답이 이 논문의 다음 장을 결정할 것이다.
경쟁 가설과 반론
첫 번째 반론은 일반화다. 시험대는 따뜻한 비의 충돌·병합 한 가지다. 대류, 얼음 구름, 난류로 확장할 수 있는지는 이 실험이 답하지 않는다. 두 번째 반론은 비교의 공정성이다. 에이전트가 만든 코드는 JAX로 미분 가능하게 작성되었고, 재조율된 물리 방안은 그렇지 않을 수 있다. 미분 가능성은 훈련과 조율의 비용을 바꾸므로, '계산 비용이 낮다'는 비교가 무엇을 포함하는지가 중요하다.
세 번째 반론은 저자 자신이 요약에서 이미 인정한 부분이다. 감독 없는 성능이 방안과 모델에 크게 의존한다면, 10개 모델의 평균이나 중앙값은 그 자체로 어떤 모델의 능력을 말해주지 않는다. 이 논문은 '어떤 모델이 최고'라는 순위표가 아니라, '어떤 조건에서 코드 생성이 의미를 갖는가'에 대한 조건표로 읽어야 한다.
비를 뿌리기 직전의 적운. 따뜻한 비는 얼음 과정 없이 물방울끼리 부딪쳐 합쳐지는 충돌·병합으로 만들어진다. — Joydeep, CC BY-SA 3.0 (Wikimedia Commons)
논문이 스스로 인정한 한계
요약에서 저자가 직접 밝힌 한계는 분명하다. 감독 없는 실행의 성능이 방안과 언어모델에 강하게 의존한다는 것, 그리고 실험이 따뜻한 비라는 단일 사례에 묶여 있다는 것이다. 10종의 모델을 썼다는 사실은 폭을 넓히지만, 각 모델의 세부 설정과 프롬프트 이력이 공개되지 않으면 재현은 어렵다. 논문은 이 점을 숨기지 않는다.
또 하나 주의할 것은 '실행 가능하고 질량을 보존하는 코드'가 '옳은 물리'와 같지 않다는 점이다. 질량 보존은 필요조건이지 충분조건이 아니다. 논문이 내세우는 것은 코드의 물리적 정당성이 아니라, 고해상도 기준에 견줬을 때의 오차다. 이 구분을 놓치면 2/100을 과대평가하게 된다.
독자에게 던지는 질문
지구시스템 모델의 매개변수화는 오랫동안 '전문가의 손'이 만드는 물건이었다. 이 논문은 그 손의 일부를 값싼 탐색으로 대체할 수 있는지 묻는다. 100번 중 2번이라는 성공률은 낮아 보이지만, 실패한 98번의 비용이 거의 0이라면 이야기가 달라진다. 문제는 우리가 그 2번을 어떻게 알아보느냐다.
당신이라면 100개의 후보 중 2개를 어떻게 골라내겠는가. 홀드아웃 오차가 가장 낮은 것을 고르는 일은 쉽다. 그러나 그 2개가 왜 통했는지 설명하지 못한다면, 우리는 다음번에도 100번을 던져야 한다. 과학에서 우리가 원하는 것이 성능인지 이해인지, 이 논문은 그 질문을 구름 한 점에 얹어 놓았다.
참고 자료
Kara D. Lamb, "Can LLM Agents Improve Imperfect Earth System Model Parameterizations?", arXiv:2611.03543v1 (2026-11-02). https://arxiv.org/abs/2611.03543v1
본문의 수치(100개 중 2개, 10개 모델 중 8개 개선, 재조율 물리 방안의 비용 우위)는 모두 위 논문의 초록에 명시된 값이며, 초록에 없는 내용은 '논문은 주장한다'로 한정해 서술했다.
댓글2
모든 이야기1654
가벼운 안부부터 깊은 생각까지, 함께 나눠요.