소나기
보상이 두 개의 봉우리로 갈라진 공간을 상상해 보자. 왼쪽 봉우리에서 10점, 오른쪽 봉우리에서도 10점이 나온다. 강화학습은 이때 어떻게 움직일까. 직관적으로는 양쪽을 반씩 오가는 정책이 최선처럼 보인다. 그런데 실제 정책경사(policy gradient) 학습에서는 종종 한쪽 봉우리만 남기고 다른 쪽을 통째로 잊어버린다. 점수는 여전히 10점이니 손실 함수는 만족스러운 얼굴을 하고, 학습 로그에는 아무 문제도 찍히지 않는다. 사라진 것은 숫자가 아니라 선택지다.
arXiv 2611.04792로 2026년 11월 3일 공개된 논문 Density-Aware Reward Scaling: A Reinforcement Learning Framework for Reward-Proportional Sampling은 바로 이 지점을 겨냥한다. 저자는 Ria Shekhawat, Abhijeet Sinha, Yingtao Zhu, Dianbo Liu 네 명이다. 이들이 제안하는 DARS는 모델 구조를 바꾸지도, 새로운 신경망을 하나 더 붙이지도 않는다. 보상 값에 손을 대는, 이름 그대로 '보상 스케일링' 하나로 문제를 건드린다.
같은 10점인데 왜 한쪽만 살아남는가
강화학습 목표는 기대 보상을 최대화하는 것이다. 수식으로는 단순하지만, 이 목표에는 '어디에 얼마나 많이 모여 있는지'에 대한 항이 없다. 보상이 10점인 지점이 하나든 열 개든 목표값은 같다. 그래서 최적화는 더 배우기 쉬운 쪽으로 미끄러진다. 이미 조금이라도 확률이 높은 봉우리를 더 밀어주면 기대 보상이 빨리 오르기 때문이다. 이것이 논문이 말하는 단일 모드 붕괴(single-mode collapse)다.
GRPO 같은 그룹 기반 방법에서 이 경향은 특히 또렷하다. 같은 프롬프트로 여러 개의 롤아웃을 뽑아 그 안에서 상대적인 우열을 매기는데, 그룹 안에서 이미 우세한 답변이 반복적으로 선택되면 다음 그룹은 그 답변 주변에서 다시 뽑힌다. 데이터가 스스로를 좁히는 되먹임이다. 점수는 오르는데 출력의 종류는 줄어드는, 겉으로는 성공처럼 보이는 상태가 여기서 만들어진다.
보상을 밀도로 나눈다는 발상
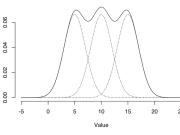
DARS가 하는 일은 한 문장으로 설명된다. 각 롤아웃 그룹 안에서 결과들이 국소적으로 얼마나 빽빽하게 모여 있는지를 추정하고, 보상을 그 밀도로 나눈다. 많이 몰린 곳의 보상은 깎이고, 드문 곳의 보상은 상대적으로 커진다. 논문의 표현을 빌리면 '보상에 비례하는 샘플링(reward-proportional sampling)'을 유도하는 것이다.
중요한 것은 이 밀도를 학습된 모델로 구하지 않는다는 점이다. 별도의 밀도 추정망도, 크리틱도, 보조 목적함수도, 정책경사 목적 자체의 수정도 없다. 같은 그룹 안의 샘플들만 보고 밀도를 어림한다. 그래서 기존 파이프라인에 몇 줄을 얹는 것으로 끝난다. 새 아키텍처를 처음부터 학습시키는 방법들과 비교하면 진입 비용이 사실상 없다는 것이 이 방법의 가장 큰 미덕이다.
여러 개의 정규분포가 겹쳐 만들어진 다봉 밀도 함수 — DARS가 다루는 '봉우리가 여럿인 보상 공간'의 모습이다. Smason79, CC BY-SA 3.0 (Wikimedia Commons)
반직관적인 결론: 상을 깎았는데 선택지가 늘었다
보상을 나누면 총보상은 줄어든다. 밀도가 1보다 크면 나눈 값이 원래보다 작아지기 때문이다. 상을 깎았으니 성능이 떨어질 것 같지만, 논문이 보고하는 결과는 반대다. 다봉 항법(multimodal navigation)을 통제한 과제에서 DARS를 적용한 GRPO는 일반 GRPO가 보이는 단일 모드 붕괴를 피하고, 목표로 삼은 모드 배분을 거의 회복했다고 저자들은 주장한다.
텍스트-이미지 프롬프트 적응 과제에서도 같은 방향의 결과가 나온다. 데이터셋과 정책 언어모델, 보상 설정을 바꿔가며 실험했을 때 이미지와 프롬프트의 다양성이 일관되게 개선되었고, 의미 정합성은 유지되었다고 한다. 여기서 눈에 띄는 것은 '다양성과 정합성의 맞교환'이 일어나지 않았다는 서술이다. 다양성을 얻으려면 관련성을 조금 포기해야 한다는 것이 흔한 통념인데, 이 실험은 그 통념이 필연이 아닐 수 있음을 시사한다.
두 개의 봉우리를 가진 히스토그램. 한쪽 봉우리만 남는 것이 논문이 말하는 단일 모드 붕괴이며, DARS는 두 봉우리의 비율을 되찾는 것을 목표로 한다. Brigban, CC0 (Wikimedia Commons)
왜 이런 일이 생기는지 생각해 보면 이렇다. 밀도로 나누는 조작은 보상의 절대값을 바꾸는 것이 아니라 그룹 안에서의 상대적 순위를 눌러주는 것이다. 이미 우세한 봉우리에 몰린 샘플들은 밀도가 높아 보상이 깎이고, 아직 덜 탐색된 봉우리에서 나온 샘플은 밀도가 낮아 상대적으로 살아남는다. 결과적으로 정책은 '가장 좋은 답 하나'가 아니라 '좋은 답들의 분포'를 따라가게 된다.
경쟁 가설: 그냥 엔트로피를 키우면 되지 않나
가장 먼저 떠오르는 반론은 엔트로피 보너스다. 정책의 출력 분포를 평평하게 만들면 다양성이 늘어난다는 것은 강화학습의 오래된 상식이다. 그러나 엔트로피 항은 보상의 구조를 보지 않는다. 보상이 낮은 무의미한 출력과 보상이 높은 대안을 똑같이 '덜 선택된 것'으로 취급한다. 그 결과 다양성은 늘지만 그 다양성이 쓸모 있는 곳에 몰리지 않을 수 있다.
KL 페널티나 다양성 보상(diversity reward)을 직접 더하는 방법도 후보군이다. 다만 이런 항들은 대개 새로운 하이퍼파라미터를 끌고 들어오고, 그 값에 따라 성능이 크게 흔들린다. DARS는 보상 값 자체를 그룹 내 밀도로 나누는 방식이라 별도의 가중치를 추가하지 않는다는 점을 차별점으로 내세운다. 물론 이것이 '하이퍼파라미터가 전혀 없다'는 뜻은 아니다. 밀도를 어떤 척도로, 어떤 대역폭으로 어림하는지에 따라 결과가 달라질 수 있고, 논문은 그 선택을 어떻게 했는지 방법 절에서 다룬다.
이 방법이 이기지 못할 수도 있는 지점
또 하나의 반론은 '보상이 원래 하나의 봉우리뿐인 과제'에서는 이득이 없을 것이라는 것이다. 밀도가 고르게 높으면 나누는 값이 거의 균일해져 DARS는 사실상 아무 일도 하지 않는다. 즉 이 방법은 다봉 구조가 실제로 존재하는 과제에서만 의미가 있다. 논문이 다봉 항법이라는 통제 과제를 고른 이유도 여기에 있다. 통제된 환경에서는 정답 분포를 알 수 있으니 '모드 배분을 회복했다'는 주장을 검증할 수 있다.
비판적으로 읽어야 할 부분도 분명하다. 텍스트-이미지 실험에서 '다양성'은 사람이 느끼는 다양성인지, 임베딩 거리 같은 대리 지표인지에 따라 결론이 달라진다. 초록만으로는 그 측정 방식이 드러나지 않으므로, 다양성이 개선되었다는 서술은 저자들의 측정 정의 위에서만 성립한다고 읽는 것이 안전하다. 같은 이유로 '의미 정합성이 유지되었다'는 문장도 어떤 정합성 지표로, 어떤 기준선과 비교했는지를 방법 절에서 확인해야 한다.
논문이 스스로 인정한 한계
초록 수준에서 저자들이 분명히 밝히는 것은 이 방법이 기존 강화학습 파이프라인 안에서 쓰이는 '가벼운(lightweight)' 수단이라는 성격 규정이다. 다시 말해 새로운 이론적 보장을 제시하는 논문이 아니라, 이미 돌아가고 있는 GRPO 계열 학습에 얹는 실용적 보정 장치로 자리매김한다. 두 개의 과제군, 즉 통제된 항법 과제와 프롬프트 적응 과제에서의 결과가 근거의 전부라는 점도 이 성격과 맞닿아 있다.
여기서 독자가 스스로 물어야 할 것은 밀도 추정의 분산이다. 밀도는 같은 그룹 안의 샘플만으로 어림하므로 그룹 크기가 작으면 추정이 거칠어진다. 롤아웃 수를 줄여 비용을 아끼려는 설정에서 이 거친 추정이 어떤 잡음을 만드는지는, 초록이 답해 주지 않는 영역이다. 논문은 이 지점을 '주장'으로 덮지 않고 실험 조건으로만 말하고 있으니, 실제 적용 전에 그룹 크기별 민감도를 확인하는 것이 합리적이다.
독자에게: 우리는 왜 늘 하나만 남기는가
이 논문이 흥미로운 이유는 기계학습의 기술을 넘어선다. 보상이 같은 여러 선택지 중 하나만 남기는 현상은 모델 튜닝에만 국한되지 않는다. 평가 지표가 하나뿐인 조직은 그 지표에서 높은 점수를 내는 한 가지 방식을 반복하고, 나머지 가능성은 학습 데이터에서 서서히 사라진다. 사라진 가능성은 점수표에 흔적을 남기지 않는다는 점에서 단일 모드 붕괴와 정확히 같은 구조다.
DARS의 처방은 그 구조에 대한 답이기도 하다. 이미 많이 몰린 곳의 성과를 덜 쳐주고, 드물게 나온 좋은 결과를 상대적으로 더 쳐주는 것. 물론 이 처방에는 '드문 것이 좋은 것'이라는 보장이 없다. 그래서 밀도로 나눈 보상은 어디까지나 탐색의 균형을 맞추는 장치이지, 가치 판단을 대신하는 장치는 아니다.
여러분이라면 어떤 기준으로 '덜 선택된 좋은 답'을 알아보시겠는가. 그리고 그 기준을, 점수가 오르는 동안에도 계속 신뢰할 수 있겠는가.
참고 자료
Ria Shekhawat, Abhijeet Sinha, Yingtao Zhu, Dianbo Liu, Density-Aware Reward Scaling: A Reinforcement Learning Framework for Reward-Proportional Sampling, arXiv:2611.04792 (cs.AI), 2026-11-03. https://arxiv.org/abs/2611.04792
이미지 출처: Wikimedia Commons — Gaussian mixture example (Smason79, CC BY-SA 3.0), Bimodal distribution (Brigban, CC0).
댓글1
-
빗방울
2026.11.04 12:41
밀도로 나눈 보상이 결국 '탐색의 균형' 장치라는 대목이 제일 궁금했습니다. 그룹이 작아서 밀도 추정이 거칠어지면, 깎이는 쪽이 우연히 몰린 샘플이 되어 보상 잡음만 커지지 않을까요? 롤아웃 수를 줄이는 설정에서는 DARS가 오히려 역효과를 낼 수도 있지 않을까요? arXiv:2611.04792
모든 이야기1768
가벼운 안부부터 깊은 생각까지, 함께 나눠요.