소나기
2026년 11월 5일, arXiv에 2611.08478v1이라는 논문 한 편이 올라왔다. 제목은 「Scientist World: Grow a Research World for AI-Scientists」. 저자는 Taiming Lu, Sachin Konan, Zhuang Liu 세 사람이다. 이들이 첫 문장에서 던지는 장면은 논문 목록이 아니라 실행 환경 1,000개다. 논문 한 편이 하나의 환경이 되고, 그 환경에 들어간 AI가 그 논문의 열린 질문을 붙잡고 자기 실험을 돌린다.
책을 읽을 수는 있지만 돌릴 수는 없었다
논문은 AI 과학자에게 늘 읽을 수 있는 것이었다. 초록을 요약하고, 수식을 파싱하고, 참고문헌 그래프를 그리는 일은 이미 잘한다. 문제는 그다음이다. 인간 과학자는 수백 년치 열린 문제와 공유된 아이디어를 자기 실험실에서 곧바로 굴려 볼 수 있다. AI에게 그 세계는 readable but not runnable, 즉 읽을 수는 있어도 실행할 수는 없는 상태였다.
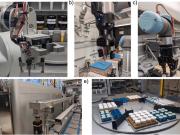
자율 실험실의 로봇 팔이 시료를 옮기는 모습 — A-Lab(무기화학 자율 실험실)의 시료 이송 장비. Szymanski 외 연구진, CC BY 4.0 (Wikimedia Commons)
이 논문이 만든 것은 그 간극을 메우는 파이프라인이다. 자동화된 절차가 각 논문에서 열린 형태의 연구 질문을 추출하고, 논문이 제안한 방법을 그대로 재현해 기준선(baseline)으로 세운다. 그다음 AI 과학자를 환경에 들여보내고, 인간 저자들이 실제로 달성한 성과와 비교해 채점한다. 사람이 세운 기록이 곧 시험지가 되는 구조다.
74%라는 숫자가 뜻하는 것
저자들이 공개한 첫 배치는 검증된 환경 1,000개다. 그리고 이 세계를 평가장으로 쓰자, 최전선(frontier) AI 과학자들이 인간 연구자를 74%의 확률로 앞선다는 결과가 나왔다고 논문은 주장한다. 이 숫자는 "AI가 논문을 잘 쓴다"와 전혀 다른 말이다. 인간이 실제로 했던 일을, 같은 조건에서, 더 나은 쪽으로 끝냈다는 뜻으로 읽히기 때문이다.
여기서 반전은 방향이다. 보통 벤치마크는 사람이 만든 문제를 AI가 푸는 구조다. 이 논문은 반대로 사람이 이미 통과한 시험을 AI에게 다시 치르게 하고, 그 답안을 사람의 답안과 비교한다. 기준선이 논문 자체이므로, 채점표를 만드는 사람과 채점받는 사람이 같은 문헌 위에 서게 된다.
6,400시간의 실패 기록
이 세계에는 부산물이 하나 더 붙어 있다. 6,400시간 분량의 연구 흔적(research traces)이다. 아이디어, 실험, 실패, 성공이 모두 남는다고 논문은 적는다. 실패가 기록으로 남는다는 점이 눈에 띈다. 논문 목록만 보면 과학은 성공의 연속처럼 보이지만, 실제 연구의 대부분은 실패한 시도이고 그 실패는 거의 출판되지 않는다.
그래서 이 데이터는 평가용이면서 동시에 학습용이다. 무엇이 안 되는지를 아는 것이 무엇이 되는지를 아는 것만큼 값어치가 있다는 발상이다. AI 과학자를 키우는 교재가 논문 요약본이 아니라 시행착오 로그라는 셈이다.
작은 모델을 158% 끌어올린 훈련장
논문은 이 세계를 훈련장으로 쓸 때의 수치도 제시한다. 작은 모델의 연구 아이디어 발상 능력을 +158% 끌어올려 최전선 모델과 견줄 수준까지 올렸다고 주장한다. 평가와 훈련이 같은 환경에서 돌아간다는 것이 이 구성의 핵심이다. 시험장을 따로 만들지 않고, 시험장에서 바로 배우게 한다.
이 주장이 성립하려면 환경이 스스로 늘어나야 한다. 논문의 표현은 "science itself에서 자라나고, science itself와 함께 자란다"이다. 새 논문이 나오면 새 환경이 생기고, 그 환경이 다시 다음 세대의 훈련 재료가 되는 순환이다. 1,000개는 시작점이라는 뜻으로 읽힌다.
반론: 채점하는 쪽이 이미 오염되어 있다면
가장 먼저 나올 반론은 벤치마크 오염이다. 최전선 모델은 방대한 논문을 학습했다. 그 논문들이 곧 시험 문제라면, AI는 문제를 푼 것이 아니라 답을 기억한 것일 수 있다. 이 반론은 "74%"라는 숫자의 무게를 크게 깎는다. 논문은 재현 기준선을 세워 이 문제를 줄이려 하지만, 초록만으로는 학습 데이터와 평가 환경이 얼마나 분리되었는지 확인되지 않는다.
시료 플레이트를 옮기는 산업용 로봇 팔 — 자동화된 실험실에서 사람 대신 반복 실험을 도맡는 장비. Maggie Bartlett, NHGRI, 퍼블릭 도메인 (Wikimedia Commons)
두 번째 반론은 기준선의 품질이다. 자동 파이프라인이 논문의 방법을 재현했다고 할 때, 그 재현이 원 논문과 동등한지 판정하는 것은 또 다른 문제다. 재현이 어긋나 기준선이 약해지면 AI가 이기는 비율은 부풀려진다. 세 번째는 무엇을 더 나은 성과로 볼 것인가다. 지표를 하나로 정할 수 없는 연구 질문에서 74%는 단일한 승패가 아니라 특정 척도 위의 승률일 수 있다.
논문이 밝히지 않은 것
이 글에서 확인한 범위, 즉 공개된 초록에는 저자들이 인정한 한계가 명시되어 있지 않다. 실패한 환경의 비율, 1,000개를 검증했다는 기준이 무엇인지, 74%가 어떤 지표와 표본 위에서 계산되었는지도 초록에는 없다. 이 항목들은 논문 본문에서 확인해야 할 몫으로 남겨 둔다. 확인되지 않은 것을 확인된 것처럼 쓰지 않는 것이 이 글의 규칙이다.
다만 구조적으로 분명한 긴장은 있다. AI가 인간을 이겼다는 주장과, 그 AI를 키운 재료가 인간의 논문이라는 사실은 서로를 완전히 지우지 못한다. 재료를 준 쪽과 재료로 이긴 쪽이 같은 세계에 산다는 것이 이 논문이 남기는 가장 흥미로운 모순이다.
독자에게
만약 당신의 연구실에 이런 환경이 들어온다면, 가장 먼저 무엇을 맡기겠는가. 논문 재현일까, 새 가설 생성일까, 아니면 실패 로그 정리일까. 그리고 AI가 74%의 확률로 당신보다 나은 답을 낸다면, 그 74%를 성과로 인정할 것인가, 아니면 대리 계산으로 볼 것인가.
이 논문은 "AI 과학자의 세계가 도착했다"고 선언한다. 선언이 사실이 되려면 남은 것은 숫자가 아니라 검증 절차다. 그 절차를 누가 설계하는지가 다음 10년의 과학을 결정할 것이다.
참고 자료
Lu, T., Konan, S., & Liu, Z. (2026). Scientist World: Grow a Research World for AI-Scientists. arXiv:2611.08478v1 [cs.AI]. https://arxiv.org/abs/2611.08478v1
이미지 1: A-Lab 시료 이송 로봇 설치 — Szymanski et al., CC BY 4.0, Wikimedia Commons. 이미지 2: Chemical Genomics Robot — Maggie Bartlett / NHGRI, 퍼블릭 도메인, Wikimedia Commons.
댓글1
-
빗방울
2026.11.06 17:39
6400시간 실패 로그가 진짜 부산물인 것 같아 🔥 논문 요약본보다 그게 더 값어치 있어 보임 👍
모든 이야기2139
가벼운 안부부터 깊은 생각까지, 함께 나눠요.