소나기
바닥에 떨어진 베개를 줍는 일은 사람에게 3초짜리다. 허리를 굽히고, 손을 뻗고, 집어 올리면 끝이다. 그런데 같은 일을 로봇에게 시키면 이야기가 달라진다. 베개가 어디 있는지 찾아야 하고, 팔이 닿도록 몸을 돌려야 하고, 허리를 숙이는 동안 무게 중심이 앞으로 쏠리지 않게 다른 관절을 동시에 접어야 한다. 카메라가 팔에 달려 있으면 집는 순간 손이 시야를 가린다. 2026년 11월 2일 arXiv에 올라온 논문 「Pixel: A Co-Designed Full-Stack Robot System for Learning General-Purpose Mobile Manipulation」은 이 3초짜리 일이 왜 그렇게 오래 걸리는지를 묻는 논문이다.
저자는 카네기멜런대의 Tony Tao, Jason Jingzhou Liu(공동 1저자), Ruslan Salakhutdinov, Deepak Pathak(공동 지도)이다. arXiv 번호는 2611.03648이고, 프로젝트 페이지의 BibTeX가 밝히는 분류는 cs.RO다. 이 글은 초록과 프로젝트 페이지에 공개된 내용만 근거로 쓴다. 논문 PDF의 실험 수치표는 아직 확인하지 못했으므로, 성공률 같은 숫자는 인용하지 않는다.
한 대의 로봇을 네 조각으로 나눠 만들면
논문의 출발점은 로봇 자체가 아니라 조직도다. 범용 이동형 조작에는 네 가지가 필요하다. 성능 좋은 하드웨어, 대량으로 모을 수 있는 시연 데이터, 전신을 아우르는 제어기, 그리고 정책 학습 파이프라인이다. 문제는 이 네 가지가 보통 서로 다른 연구실, 다른 논문, 다른 회사에서 따로 개발된다는 점이다. 논문은 그 결과로 생기는 어긋남(mismatch)이 개별 부품의 성능을 다 합친 것보다 낮은 전체 성능을 만든다고 주장한다.
그래서 이 팀이 택한 방법은 넷 중 하나를 잘 만드는 것이 아니라 넷을 한 번에 맞춰 설계하는 것이다. 논문이 스스로 붙인 이름이 co-designed full-stack, 즉 공동 설계된 전체 스택이다. 하드웨어, 데이터 수집, 제어, 학습을 하나의 결정 흐름 안에 넣고, 각 부품이 다른 부품의 제약을 미리 알고 만들어지게 했다. 이 선택은 논문의 강점이자 약점이 된다. 부품을 따로 떼어 성능을 재기 어려워지기 때문이다.
몸을 사람 쪽으로 옮긴다는 선택
가장 눈에 띄는 결정은 오차를 소프트웨어로 메우지 않고 몸을 옮겼다는 점이다. 사람의 시연을 로봇에게 옮길 때 보통 걸리는 문제는 구현체 차이다. 키, 팔 길이, 관절 자유도, 눈높이가 다르니 사람이 찍은 영상과 손 궤적을 그대로 학습시키면 정책이 흔들린다. 흔한 대응은 알고리즘을 그 차이에 강하게 만드는 것이다. Pixel은 대신 로봇의 운동학을 사람에 맞추고, 카메라 시점과 그리퍼 형상을 사람의 것과 정렬했다. 값싼 바퀴형 휴머노이드에 순응형 그리퍼를 달아, 애초에 격차가 작게 태어나게 만든 셈이다.
논문은 이 배치를 '사람과 로봇의 시연을 하나의 파이프라인에서 학습할 수 있는 공통 행동 공간'으로 설명한다. 사람이 남긴 데이터와 로봇이 남긴 데이터가 같은 좌표계 위에 놓이면, 데이터 양을 늘리는 일과 알고리즘을 바꾸는 일이 분리되지 않는다. 하드웨어가 학습 곡선의 일부가 되는 구조다.
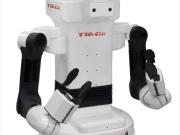
바퀴형 이동형 조작 로봇의 예. 몸통에 두 팔이 달린 형태로, Pixel이 겨냥한 부류의 플랫폼이다 — PAL Robotics, CC BY-SA 4.0 (Wikimedia Commons)
로봇 없이 로봇 데이터를 모은다
로봇 학습에서 가장 비싼 것은 로봇이다. 한 대로 한 번에 한 사람만, 한 번에 한 작업만 시연할 수 있고, 고장 나면 학습이 멈춘다. 그래서 이 팀은 3D 프린팅으로 만든 값싼 센서화 인간 데이터 수집 장비를 따로 만들었다. 손의 미세한 조작을 기록하면서, 케이블 없이 걸어 다니며 전신 이동 데이터를 모을 수 있게 한 것이 핵심이다. 로봇이 없어도 로봇에 쓸 데이터가 쌓이는 구조다.
텔레오퍼레이션 인터페이스도 세 갈래로 나눠 비교했다. 3D 프린팅한 리더 암, VR 조이스틱, 그리고 조작자의 몸 움직임을 그대로 따라가는 VR 바디 트래킹이다. 프로젝트 페이지는 셋을 서로 보완적인 인터페이스로 소개한다. 정밀한 손 작업에는 리더 암, 넓은 공간을 걸어 다니며 하는 작업에는 바디 트래킹이 맞는다는 식이다. 여기서도 공통점은 하나다. 어떤 인터페이스로 모은 데이터든 같은 전신 제어기와 같은 행동 공간을 거쳐 학습으로 들어간다.
느린 두뇌, 빠른 손
정책은 두 층으로 나뉜다. 위층은 비전언어모델이다. 사용자의 음성 명령과 상호작용 맥락, 그리고 시각적 키프레임을 받아 하위 작업을 계획하고 사용자에게 응답한다. 아래층은 언어 조건부 정책으로, 머리 카메라와 손목 카메라 영상을 함께 보고 DiT 기반 플로 매칭 모델로 행동 열을 예측한다. 머리만 보면 진공청소기의 전원 버튼처럼 작은 것을 누를 때 필요한 근접 디테일이 사라지고, 손목만 보면 몸 전체가 어디를 향하는지 모른다. 두 시점을 같이 넣는 이유가 여기에 있다.
이 예측을 실제 관절로 옮기는 것이 전신 제어기다. 논문은 기하학적 패브릭(geometric fabrics)이라는 제어 기법을 쓴다고 밝힌다. 부드럽고 안전한 움직임을 만들면서 텔레오퍼레이션과 정책 실행에 같은 인터페이스를 제공하는 것이 목표다. 사람이 조작할 때와 정책이 스스로 움직일 때 같은 제어기를 지나가므로, 학습 데이터와 실행 사이에 별도의 변환이 끼어들지 않는다.
이동형 조작 플랫폼의 다른 예. 바퀴로 이동하고 팔로 조작하는 구조는 같지만 관절 구성과 시점이 달라, 시연을 그대로 옮기면 충돌과 자세 오차가 남는다 — Auledas, CC BY 4.0 (Wikimedia Commons)
반직관적인 결론: 알고리즘이 아니라 기준 좌표계가 갈랐다
프로젝트 페이지에 공개된 절제 실험이 이 논문에서 가장 흥미로운 부분이다. 머리를 고정하면 로봇은 사람처럼 눈만 돌릴 수 없어서, 몸 전체를 돌려 한쪽을 선택하고 만다. 즉 능동적 시각 탐색이 사라진다. 머리 카메라만 쓰면 청소기 전원 버튼 같은 세밀한 조작이 어려워진다. 행동 공간을 상대 좌표만으로 정의하면 공유 기준 프레임이 없어 양팔 협응이 무너지고 시간이 지나며 행동이 흘러간다. 화려한 정책 구조가 아니라, 목이 돌아가는지와 좌표계를 어디에 두는지가 성능을 갈랐다는 뜻이다.
이 결과는 논문의 주장을 뒤집어 보여준다. 범용 이동형 조작의 병목은 더 똑똑한 학습 알고리즘이 아니라, 부품 사이의 인터페이스 설계일 수 있다는 것이다. 논문은 이 주장을 언어 조건 하나만 바꿔 여러 작업을 몇 분에 걸쳐 수행하는 단일 정책, 그리고 새로운 물체와 낯선 환경 배치에도 반복 실행이 유지되는 장면으로 뒷받침한다. 다만 이는 시연 영상과 서술로 제시된 것이지, 통합 성공률 표로 제시된 것이 아니다.
경쟁 가설: 더 큰 정책, 더 많은 데이터
반론은 세 갈래다. 첫째, 정책을 키우고 데이터를 늘리면 구현체 차이는 자연히 흡수된다는 가설이다. 대규모 비전언어행동 모델 계열의 주장과 맞닿아 있다. 둘째, 시뮬레이션에서 강화학습으로 먼저 배우고 현실로 옮기면 값싼 하드웨어 조정이 필요 없다는 가설이다. 셋째, 전신 제어와 조작을 별도 전문가로 나누고 상위에서 조정하면 공동 설계 없이도 같은 결과가 나온다는 가설이다.
이 논문은 셋을 정면으로 반박하는 비교표를 제시하지 않는다. 오히려 공동 설계라는 방법 자체가 그런 비교를 어렵게 만든다. 하드웨어를 바꾸면 데이터 분포가 바뀌고, 제어기를 바꾸면 행동 공간이 바뀌어서 한 부품만 교체한 대조군을 만들 수 없다. 필자는 이 점을 논문의 설득력에 대한 실질적 반론으로 본다. '네 부품을 맞춰 설계했다'는 주장은 강하지만, 어느 부품이 얼마를 기여했는지는 이 구조로는 답하기 어렵다.
논문이 스스로 인정하는 한계, 그리고 독자에게
논문은 결론에서 이 시스템이 통합되고 확장 가능한 토대가 되기를 바란다고 말한다. 이는 곧 벤치마크에서 이겼다는 주장이 아니라는 뜻이다. 평가는 하드웨어, 데이터 수집, 정책 학습이라는 세 축에 걸쳐 수행되었다고 서술되지만, 프로젝트 페이지에는 과제별 성공률이나 실패율 표가 공개되어 있지 않다. '값싼(low-cost)'이라는 표현도 페이지에는 구체적 단가가 붙지 않는다. 코드는 공개 예정(Open Sourced Soon)으로 표시되어 있어, 이 글을 쓰는 시점에는 재현이 불가능하다. 바퀴형이라는 선택도 한계다. 계단과 험지는 이 플랫폼의 범위 밖이다.
그래도 이 논문이 던지는 질문은 남는다. 로봇이 못하는 일을 만나면 우리는 대개 모델을 키우거나 데이터를 더 모은다. 그런데 목이 고정된 로봇에게 아무리 좋은 정책을 얹어도 그 로봇은 고개를 돌릴 수 없다. 독자에게 묻고 싶다. 지금 우리가 'AI가 부족해서'라고 부르는 실패 중 얼마가, 사실은 좌표계와 관절 범위와 카메라 위치 같은 지루한 설계 결정의 문제일까. 그리고 그 결정을 학습 이후에 고치려 드는 습관이, 애초에 고칠 수 없는 것을 고치고 있는 것은 아닐까.
참고 자료
Tao, T., Liu, J. J., Salakhutdinov, R., & Pathak, D. (2026). Pixel: A Co-Designed Full-Stack Robot System for Learning General-Purpose Mobile Manipulation. arXiv:2611.03648 [cs.RO]. https://arxiv.org/abs/2611.03648v1
프로젝트 페이지(과제 시연, 절제 실험, BibTeX): https://pixel-robot.com/pixel
이미지 출처: TIAGo++ 사진 — PAL Robotics, CC BY-SA 4.0, Wikimedia Commons. ER-FLEX 이동형 조작 로봇 — Auledas, CC BY 4.0, Wikimedia Commons.
댓글1
-
빗방울
2026.11.04 04:29
목이 고정된 로봇한테 좋은 정책 얹어봤자 고개 못 돌리는 건 그대로라는 대목 ㅇㅇ 알고리즘 키우는 걸로 다 해결될 거라는 생각이 은근 위험함. 바퀴형이라 계단 포기한 것도 솔직하고 좋네ㅋㅋ 코드 공개되면 절제 실험 숫자부터 보고 싶다
모든 이야기1717
가벼운 안부부터 깊은 생각까지, 함께 나눠요.
총 1717개의 이야기