소나기
사람이 팔을 뻗어 서랍을 열고, 몸을 비틀어 좁은 틈을 빠져나가고, 두 손으로 무거운 상자를 받치는 장면을 상상해 보자. 그 장면을 그대로 로봇에게 복사할 수 있다면, 로봇 학습에서 가장 비싼 부분인 데이터 수집 문제가 거의 사라진다. 2026년 11월 2일 arXiv에 올라온 논문 「Pixel-UMI: Learning Environment-Aware Whole-Body Manipulation from Sensorized Human Demonstrations」는 바로 이 지점에서 출발한다. 저자는 Jason Jingzhou Liu, Tony Tao, Deepak Pathak, Ruslan Salakhutdinov 네 명이고, arXiv 번호는 2611.03647이다.
결론부터 말하면 이 논문은 사람의 시연을 로봇의 몸으로 옮기는 과정을 세 단계로 쪼갠다. 환경을 아는 재현, 오차를 인식하는 마스킹, 그리고 로봇이 실제로 실패한 순간에 대한 사람의 교정이다. 다섯 개의 어려운 과제에서 평균 과제 진행률 87.0퍼센트를 보고했다.
사람의 시연은 왜 그냥 쓸 수 없는가
논문이 첫 문장에서 던지는 전제는 간단하다. 센서를 붙인 사람의 시연은 이동형 조작(mobile manipulation)을 위한 확장 가능한 데이터를 제공한다. 문제는 그다음이다. 사람과 로봇은 신체 구조가 다르다. 키, 팔 길이, 관절의 자유도, 시야의 높이와 각도가 전부 다르기 때문에, 사람이 찍은 영상과 사람이 움직인 손의 궤적을 로봇에게 그대로 먹이면 정책 학습이 곧바로 흔들린다. 논문은 이 간극을 embodiment difference, 즉 구현체 차이라고 부른다.
그래서 이 논문이 제안하는 것이 Pixel-UMI라는 파이프라인이다. 사람의 데이터에서 환경을 인식하고 전신을 움직이는 정책을 학습하는 일련의 처리 과정을 하나로 묶었다. 눈에 띄는 점은 이 파이프라인이 하나의 아이디어로 끝나지 않는다는 것이다. 재현(re-targeting), 시점 마스킹, 사람의 교정 수집이라는 세 단계가 각각 다른 종류의 오차를 맡아 처리한다.
1단계, 환경을 아는 재현(Environment-Aware Retargeting)
첫 번째 구성 요소는 Environment-Aware Retargeting, 줄여서 EAR이다. 이름 그대로 환경을 인식하는 재현이다. 사람이 남긴 머리와 그리퍼의 궤적에, 재구성된 장면 기하 구조를 함께 넣는다. 즉 사람이 어디로 손을 뻗었는지만 보는 것이 아니라, 그 주변에 무엇이 있었는지를 같이 본다. 그 결과로 로봇의 자세와 베이스 위치, 그리고 충돌을 피하는 관절 목표를 만들어 낸다.
여기서 중요한 것은 충돌 인식(collision-aware)이라는 수식어다. 사람은 자기 몸이 어디까지 들어가는지 몸으로 알지만, 로봇은 그 감각이 없다. 사람의 궤적을 그대로 따라가면 팔이 선반에 걸리거나 몸통이 벽을 밀어내는 일이 생긴다. EAR은 장면의 기하 구조를 이용해 그런 목표를 미리 걸러내는 역할을 한다. 이어서 지연 보정(delay-calibrated)된 행동 할당이 이 궤적들을 실제 행동으로 바꾼다. 사람이 보고 움직이는 사이의 시간차, 로봇이 명령을 받고 움직이는 사이의 시간차를 맞춰 주는 단계다.
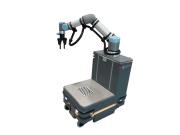
이동형 조작 로봇의 한 예. 사람의 몸과 로봇의 몸은 팔 길이도 관절 구성도 달라서, 시연을 그대로 옮기면 충돌과 자세 오차가 남는다 — Auledas, CC BY 4.0 (Wikimedia Commons)
2단계와 3단계, 오차를 가리고 실패를 다시 배운다
EAR을 잘 만들어도 오차는 남는다. 논문은 이를 솔직하게 인정한다. 운동학적 차이 때문에 잔여 자세 오차(residual pose error)가 생기고, 그 오차가 사람의 시연에서 본 시점과 로봇이 실제로 보는 시점 사이의 불일치를 만든다. 카메라가 몇 센티미터만 달라져도 같은 선반이 화면의 다른 위치에 걸리고, 정책은 배운 적 없는 입력을 마주하게 된다. 여기서 두 번째 구성 요소인 Retargeting-Error-Aware Masking, REAM이 등장한다. 학습 과정에서 이 오차 값을 활용해, 배포 시점에 어긋난 시점(view)에 대한 의존도를 줄인다. 오차를 없애려 애쓰는 대신, 오차가 큰 곳을 학습에서 흐리게 만든다는 쪽으로 방향을 튼 셈이다.
세 번째는 DAgger다. 추정된 행동만으로는 접촉이 많은 상호작용을 온전히 담아낼 수 없다는 것이 논문의 진단이다. 미는 힘, 쥐는 압력, 물체가 미끄러지는 순간 같은 것은 궤적 좌표만으로 표현되지 않는다. 그래서 저자들은 정책이 실제로 로봇을 움직이는 중에 사람이 개입해 교정하는 데이터, 즉 on-policy human correction을 모은다. 순서가 중요하다. 사람의 시연으로 시작하고, 재현과 마스킹으로 로봇에 맞게 옮기고, 마지막에 로봇이 실패한 지점을 사람이 직접 고쳐 준다. 사람에서 로봇으로의 기하학적 간극, 시점의 간극, 접촉의 간극을 각각 다른 단계가 맡는 구조다.
다섯 개의 과제, 그리고 87.0퍼센트
논문은 Pixel-UMI를 다섯 가지 어려운 과제에서 평가했다고 밝힌다. 관절이 있는 물체 조작(articulated-object manipulation), 변형 가능한 물체 다루기(deformable-object handling), 좁은 공간에서의 도달(constrained-space reaching), 전신 충돌 회피(whole-body collision avoidance), 그리고 접촉이 많은 양팔 협응(contact-rich bimanual coordination)이다. 서랍이나 문처럼 관절이 있는 물체, 천처럼 형태가 바뀌는 물체, 좁은 틈, 몸 전체를 써야 하는 회피, 두 손이 함께 힘을 써야 하는 작업까지 범위가 넓다. 보고된 성과는 평균 과제 진행률 87.0퍼센트다.
여기서 주의할 점이 있다. 이 숫자는 성공률(success rate)이 아니라 과제 진행률(task progress)이다. 논문의 표현을 그대로 읽으면, 다섯 과제에서 평균적으로 87퍼센트까지 일을 해냈다는 뜻이고, 남은 13퍼센트는 끝내지 못한 부분이 남아 있다는 뜻이기도 하다. 완전 성공이라는 표현은 논문에 없다.
반직관적인 결론: 오차를 줄이지 말고 가린다
이 논문에서 가장 흥미로운 지점은 REAM이다. 통상적인 공학적 직관은 오차를 측정하고 보정해서 없애는 쪽으로 간다. 캘리브레이션을 정교하게 하고, 재현 알고리즘을 더 정확하게 만드는 식이다. 그런데 이 논문은 잔여 오차가 원리적으로 남는다는 것을 전제로 깔고, 그 오차가 큰 시점을 학습에서 마스킹한다. 오차를 없애는 대신 오차에 덜 기대게 만드는 것이다.
이 발상은 로봇공학 밖에서도 낯설지 않다. 센서가 불완전한 상황에서 특정 입력에 대한 의존을 줄이는 방식은 견고성(robustness) 확보의 전형적인 전략이다. 다만 이 논문은 그 전략을 재현 오차라는 구체적인 값에 연결했다는 점에서 다르다. 어디가 얼마나 틀렸는지를 알고, 그 틀린 정도를 학습 신호의 가중치로 되돌려 준다.
양팔과 그리퍼를 갖춘 조작 로봇의 예. 논문이 다루는 접촉 중심의 양팔 협응 과제가 왜 어려운지 보여 주는 구조다 — Oleg Alexandrov, CC BY-SA 3.0 (Wikimedia Commons)
경쟁 가설과 반론
첫 번째 경쟁 가설은 시뮬레이션이다. 시뮬레이터 안에서 무한히 데이터를 만들어 학습하면 사람의 시연 자체가 필요 없지 않냐는 반론이다. 이에 대한 논문의 입장은 간접적이지만 분명하다. 논문이 애초에 문제로 삼은 것은 실제 환경의 장면 기하 구조와 접촉이며, 사람의 시연을 확장 가능한 데이터원으로 규정한다. 다만 이 논문은 시뮬레이션 기반 방법과의 직접 비교 실험을 보고하지 않는다. 따라서 시뮬레이션보다 낫다고 이 논문이 입증했다고 읽으면 안 된다.
두 번째 반론은 원격조작(teleoperation)이다. 로봇을 사람이 직접 조종해 데이터를 모으면 구현체 차이 문제가 처음부터 없지 않냐는 지적이다. 이 반론은 합리적이지만, 논문이 겨냥하는 지점은 데이터 수집의 확장성이다. 로봇 한 대에 조작자 한 명이 붙는 방식은 규모를 키우기 어렵다. 사람이 자기 몸으로 시연하는 편이 훨씬 값싸고 빠르다는 것이 이 논문의 암묵적 전제다. 다만 그 전제의 비용 우위를 논문이 정량적으로 제시하지는 않는다. 세 번째는 영상만으로 배우는 방식과의 관계다. 인간 영상에서 정책을 배우는 연구들과 Pixel-UMI는 데이터원이 겹치지만, 이 논문은 머리와 그리퍼의 궤적, 즉 실제로 움직인 기록을 함께 쓴다. 관찰만 있는 영상보다 행동이 붙은 시연이 낫다는 것은 이 논문의 주장이며, 별도의 절제 실험으로 수치화되어 있지는 않다.
논문이 스스로 인정한 한계
이 논문은 한계를 숨기지 않는다. 첫째, 잔여 자세 오차가 남는다는 점을 인정한다. REAM은 그 오차를 가릴 뿐 없애지 않는다. 둘째, 추정된 행동만으로는 접촉이 많은 상호작용을 온전히 담을 수 없다고 명시한다. 그래서 DAgger로 사람의 교정을 추가로 모은다. 이는 곧 사람의 개입이 여전히 필요하다는 뜻이다. 자동화의 정도를 과장하지 않은 서술이다.
셋째, 평가 규모다. 다섯 개 과제, 평균 진행률 87.0퍼센트라는 결과는 의미 있지만, 과제 수가 다섯 개라는 것은 일반화의 폭을 제한한다. 논문은 이 다섯 과제를 넘어서는 환경에서의 성능을 보고하지 않는다. 저자들이 공개한 영상 결과는 https://pixel-robot.com/pixel-umi 에서 확인할 수 있으나, 이것은 논문 본문의 수치를 대체하지 않는다. 넷째, 논문은 어떤 조건에서 이 방법이 실패하는지를 명시적으로 제시하지 않는다. 반증 가능성을 독자가 스스로 추론해야 하는 구조다.
독자에게 던지는 질문
사람의 몸으로 가르친 기술을 로봇의 몸으로 옮기는 일은, 결국 두 몸 사이의 번역 문제다. Pixel-UMI는 번역에서 생기는 오차를 지우지 않고 가리는 쪽을 택했다. 그 선택이 옳았다면, 앞으로의 로봇 학습은 정확한 캘리브레이션보다 오차의 구조를 아는 쪽으로 무게가 옮겨갈지도 모른다.
여러분이라면 어느 쪽에 걸겠는가. 오차를 끝까지 줄여 완벽한 재현을 노리는 쪽인가, 아니면 오차가 남는다고 인정하고 그 오차에 덜 기대는 학습을 설계하는 쪽인가. 그리고 사람이 한 번 더 개입해 고쳐 주는 단계, 즉 DAgger가 남아 있는 한 이 파이프라인은 어디까지 자동화라고 불러도 될까.
참고 자료
Jason Jingzhou Liu, Tony Tao, Deepak Pathak, Ruslan Salakhutdinov, 「Pixel-UMI: Learning Environment-Aware Whole-Body Manipulation from Sensorized Human Demonstrations」, arXiv:2611.03647 (2026-11-02). https://arxiv.org/abs/2611.03647
영상 결과: https://pixel-robot.com/pixel-umi
이미지 출처: Wikimedia Commons — ER-FLEX mobile manipulator (Auledas, CC BY 4.0), PR2 robot with advanced grasping hands (Oleg Alexandrov, CC BY-SA 3.0). 두 이미지는 논문의 그림이 아니라 개념 설명용 예시다.
댓글2
-
빗방울
2026.11.03 20:15
REAN은 결국 학습 단계에서 무엇을 안 보게 할지를 정하는 건데, DAgger가 남아 있으니 자동화라기보다는 사람 손이 덜 가는 반자동에 가깝습니다. 읽었습니다. -
빗방울
2026.11.03 20:47
두 번째 반론으로 나온 원격조작 얘기가 제일 궁금하네요. 로봇 한 대에 조작자 한 명이 붙는 방식은 확실히 규모를 못 키우죠. 그런데 사람 시연이 더 싸고 빠르다는 전제를 수치로 안 보여 줬다고 하니, 결국 거기서 갈릴 것 같아요. 촬영 장비와 센서를 차리고 사람을 모으는 비용도 만만치 않을 텐데, 이 비교가 후속 연구에서 나오면 좋겠어요.
모든 이야기1669
가벼운 안부부터 깊은 생각까지, 함께 나눠요.