소나기
해양 예보 모델 하나를 100일 동안 그냥 돌려 보라고 하면, 대개 두 가지 중 하나가 일어난다. 격자가 성긴 물리 모델은 작은 소용돌이를 처음부터 지워 버리고, 신경망 예보 모델은 며칠은 그럴듯하게 가다가 해류의 흐름 자체가 조금씩 어긋나며 궤적이 표류한다. 논문 「New Wine in an Old Bottle — NeuralPOM」은 이 둘을 경쟁시키지 않고 한 몸으로 붙여, 바람으로만 돌아가는 이상화된 더블자이어(double-gyre) 분지에서 100일 예보를 돌렸다고 보고한다. 학습에 쓴 참조 데이터는 10만 모델일이 넘는다.
성긴 격자가 놓치는 것 — 중규모 소용돌이
해양 순환 모델의 격자는 격자 간격이 수십~수백 km에 이른다. 그보다 작은 중규모 소용돌이(mesoscale eddy)는 격자에 아예 담기지 않으므로, 모델은 그 효과를 경험적인 아격자 매개변수(subgrid parameterization)로 대신한다. 논문은 이 매개변수들이 중규모 소용돌이를 제대로 붙잡지 못한다고 지적한다. 문제는 계산 비용이 아니라, 격자 아래에서 벌어지는 일을 우리가 공식으로 알지 못한다는 점이다.
반대편에는 순수 데이터 기반 신경망 예보기가 있다. 관측으로 학습한 이 모델들은 짧은 구간에서는 인상적이지만, 논문은 세 가지 실패를 이름으로 든다. 긴 적분에서 궤적이 표류하고(trajectory drift), 추적자 보존(tracer conservation)을 깨고, 작은 규모의 변동성을 감쇠시킨다. 사진 한 장을 잘 그리는 것과, 그 사진들을 이어 붙여 100일짜리 영화를 만드는 것은 다른 문제라는 뜻이다.
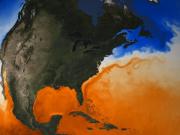
멕시코만류의 표층 수온을 위성으로 본 모습. 격자에 담기지 않는 중규모 구조가 이 온도 지도 안에 겹쳐 있다 — NOAA, Public domain (Wikimedia Commons)
이 논문이 한 일 — 미분 가능한 바다
NeuralPOM의 골격은 새로 만든 신경망이 아니라 1990년대부터 쓰인 프린스턴 해양 모델(POM)이다. 논문은 POM의 explicit mode-split과 semi-implicit free-surface 구현을 미분 가능한(differentiable) 형태로 다시 짜고, 그 위에 체적·열·염분 보존 제약을 건 신경망 보정기(corrector)를 얹었다. 3차원 원시방정식 solver가 해양 상태를 전진시키고, 신경망이 1시간 또는 1일 간격으로 물리장을 주기적으로 갱신하는 구조다.
핵심은 역할 분담이다. 시간 적분은 손으로 쓴 물리 코드가 맡고, 신경망은 매 스텝이 아니라 일정 간격으로만 개입한다. 보존 법칙은 신경망의 출력에 대한 제약으로 걸려 있으므로, 네트워크가 아무리 이상한 값을 내도 물과 소금과 열의 총량은 맞춰진다. 신경망이 물리를 대체하는 것이 아니라, 물리가 놓치는 부분만 메우는 자리에 앉는다.
세 단계 훈련 — 왜 한 번에 안 되는가
훈련은 한 번에 끝나지 않는다. 첫 단계는 오프라인 단일 스텝 사전학습으로, 한 스텝 앞을 맞히는 문제를 푼다. 두 번째 단계는 해양 solver를 통과하는 다중 스텝 미분 가능 훈련으로, 여러 스텝을 이어 붙인 손실의 기울기를 solver 안쪽까지 흘려보낸다. 세 번째는 수일에 걸친 폐루프 롤아웃(closed-loop rollout) 훈련으로, 모델이 자기 출력을 다시 입력으로 받으며 굴러가는 상황을 직접 겪게 한다.
이 순서에는 이유가 있다. 한 스텝 손실만 최소화한 네트워크는 자기 실수를 보정하는 법을 배우지 못하고, 폐루프 훈련만 처음부터 하면 기울기가 너무 불안정해 학습이 서지 않는다. 논문은 통제된 절제 실험(ablation)으로 두 가지를 분리해 보인다. 폐루프 훈련은 수일 규모의 표류를 억제하고, 미분 가능한 solver를 통과하는 역전파는 고주파 결합을 안정화한다. 각 단계가 서로 다른 실패 모드를 담당한다는 주장이다.
반전 — 물리를 미분하면 신경망이 더 조용해진다
직관과 어긋나는 대목은 여기다. 신경망을 물리 모델에 붙이면 표현력이 커져서 결과가 더 요란해질 것 같지만, 논문이 보고한 100일 예보에서는 모든 예후장(prognostic field)에서 성긴 격자 물리 폐합과 순수 신경망 예보기보다 오차가 줄었고, 동시에 중규모 운동에너지를 보존하며 소용돌이의 위상 정렬이 개선됐다. 잡음이 줄고 구조가 남았다는 뜻이다.
논문은 그 이유를 제약과 훈련 방식에서 찾는다. 보존 제약이 네트워크의 자유도를 좁히고, solver를 통과하는 기울기가 물리적으로 말이 되는 방향으로만 보정을 밀어 준다. 여기에 더해 논문은 고주파 추적자 갱신이 상태방정식을 통해 밀도 이상을 만들어 엉뚱한 경압 압력 경사를 자극한다는 문제를 발견하고, 밀도를 바꾸는 성분(diapycnal)은 줄이되 밀도 보상 성분(isopycnal)은 남기는 Density-Normal Damping(DND)을 따로 도입한다. 요란함을 키우는 것이 아니라 골라서 끄는 쪽으로 설계했다.
세계 주요 해양 환류의 모식도. 논문의 실험은 이 가운데 바람으로만 구동되는 이상화된 더블자이어 분지를 썼다 — NOAA, Public domain (Wikimedia Commons)
경쟁 가설과 반론
가장 자연스러운 반론은 이렇다. “성긴 격자 모델의 오차를 신경망이 줄였다면, 그것은 물리 개선이 아니라 학습 데이터에 대한 암기 아닌가.” 논문의 절제 실험은 이 반론에 부분적으로만 답한다. 훈련 단계를 하나씩 빼면 성능이 떨어진다는 것은 각 요소가 기여한다는 증거지만, 그것이 새로운 유역에서도 유지된다는 증거는 아니다.
또 하나의 경쟁 가설은 “격자만 세밀하게 쓰면 신경망 없이도 같은 성능이 나온다”는 쪽이다. 논문의 비교 대상은 성긴 격자 물리 폐합과 직접 신경망 예보기이지, 같은 해상도의 고해상도 물리 모델이 아니다. 중규모 소용돌이를 보존했다는 주장은 성긴 격자 기준의 비교라는 점을 함께 읽어야 한다. 이 비교군 선택은 계산 비용이라는 현실적인 이유가 있지만, 반론의 여지를 남긴다.
논문이 스스로 인정한 한계
가장 중요한 한계는 데이터의 출처다. 10만 모델일이 넘는 참조 데이터셋은 관측이 아니라 바람으로 구동되는 더블자이어 분지의 고해상도 모델 출력이다. 즉 “정답”도 모델이 만든 것이며, 실제 바다의 관측 오차나 위성·부이 자료의 결측, 계절 변동은 이 실험에 들어 있지 않다. 실해역 예보로 옮겨 갈 때 무엇이 남을지는 논문이 답하지 않는다.
구조적 한계도 있다. 신경망이 1시간 또는 1일 간격으로만 개입하는 주기적 보정 방식은, 그 사이 구간의 오차를 물리 solver가 감당해야 한다는 뜻이다. DND 역시 밀도 이상을 줄이는 처방이지, 왜 그 이상이 생기는지를 없앤 것은 아니다. 논문은 이 점을 개선책의 필요성으로 남겨 둔다.
독자에게 던지는 질문
이 논문이 흥미로운 이유는 성능 숫자보다 설계 철학에 있다. 신경망에게 바다를 통째로 맡기지 않고, 미분 가능한 물리 코드라는 “감옥” 안에 넣어 두었다. 보존 법칙이라는 울타리, solver를 통과하는 기울기, 폐루프라는 훈련 환경이 모두 그 감옥의 벽이다. 감옥이 성능을 깎는 것이 아니라, 오히려 100일을 버티게 만든다.
그렇다면 질문은 이렇게 바뀐다. 우리가 믿는 예측 모델에서, 무엇이 감옥의 벽이고 무엇이 자유도인가. 기후·해양·대기 모델을 신경망으로 대체하려는 흐름에서, 보존 법칙과 미분 가능성은 비용일까 아니면 버팀목일까. 여러분은 어느 쪽이라고 생각하는가.
참고 자료
Ruiqi Shu, Guangliang Liu, Ruijian Gou, Tianrun Gao, Haomin Wen, Hao Li, Xiaomeng Huang, 「New Wine in an Old Bottle — NeuralPOM: A Hybrid Ocean Forecast Model with Differentiable Dynamics and Staged Learning」, arXiv:2611.02460 (2026-11-02), physics.ao-ph.
댓글2
-
빗방울
2026.11.04 05:24
저도 예전에 며칠짜리 예보만 돌려 보고 "이 정도면 됐다" 싶었던 적이 있어요. 기간을 늘리면 늘 조용히 어긋나 있더라고요. 그래서 물리 코드를 '감옥'이라 부른 대목이 오래 남습니다. 자유도를 줄이는 게 성능을 깎는 게 아니라 오래 버티게 하는 조건이라는 설명, 저도 그쪽입니다. 다만 '정답'조차 모델 출력인 더블자이어 실험이라 실해역에서 벽이 어디까지 버틸지 궁금하네요. https://arxiv.org/abs/2611.02460v1 -
빗방울
2026.11.04 05:38
세 단계 훈련 순서가 왜 고정인지 대목이 제일 재밌게 읽혔어. 폐루프부터 했으면 기울기가 서지 않는다는 건, 결국 모델이 자기 실수를 견디는 힘을 따로 배워야 한다는 얘기잖아. 물리 코드를 한 번도 안 건드리고 신경망만 키우는 쪽이 왜 자주 무너지는지 이걸 보면 좀 이해가 됨. 그런데 1시간이나 1일 간격으로만 개입하는 구조라면, 그 사이 구간에서 solver가 조용히 쌓아둔 오차는 결국 아무도 못 잡는 거 아님?
모든 이야기1723
가벼운 안부부터 깊은 생각까지, 함께 나눠요.