소나기
표 하나를 펴 보자. 신호대잡음비(SNR) 6dB, 길이 121비트 LDPC 부호 (121,70). 논문의 표 I은 이 지점에서 기존 신념전파(BP)의 성능을 −ln(BER) = 13.04로 적는다. 이 숫자를 뒤집으면 비트 오류율 약 2.2×10⁻⁶, 백만 비트를 보내면 두 비트 남짓 틀린다는 뜻이다. 같은 줄의 새 방법, GBPNet은 18.32다. 뒤집으면 1.1×10⁻⁸. 같은 채널, 같은 부호, 같은 6dB에서 오류가 약 196분의 1로 줄어든다.
이 숫자는 펜실베이니아주립대 사미라 말렉(Samira Malek)이 2026년 11월 4일 arXiv에 올린 4쪽 남짓의 논문 「Learning to Decode Linear Codes with Generalized Belief Propagation Network」에 실렸다. 저자는 새 이론을 세우지 않는다. 이미 있는 디코더의 한 층을 세 층으로 쪼개고, 메시지에 학습된 배율을 곱했을 뿐이라고 말한다. 그런데 그 사소해 보이는 변형이 트랜스포머 기반 디코더들보다 낮은 오류율을 기록했다고 논문은 주장한다.
1. 표를 BER로 되돌려 읽는 법
논문의 표 I은 성능을 −ln(BER)로 적는다. 값이 클수록 좋고, 1 차이는 오류율이 e분의 1, 약 2.7분의 1이라는 뜻이다. 그래서 13.04와 18.32의 차이 5.28은 2.7의 5.28제곱, 곧 약 196배가 된다. 이 환산은 논문이 직접 적어 둔 것은 아니고 표의 정의에서 바로 따라 나오는 산수다. 읽는 사람이 직접 확인할 수 있는 종류의 숫자라는 점이 이 논문의 장점이다.
폭도 고르지 않다. BCH(63,36)에서는 4dB에서 4.03 대 6.10, 6dB에서 7.26 대 10.21로 약 19배다. 반면 Polar(64,32) 6dB에서는 6.50 대 13.85, 약 1,500배가 넘는다. 같은 구조가 어떤 부호에서는 두 자릿수, 어떤 부호에서는 네 자릿수 이득을 낸다는 뜻이고, 이 불균일함 자체가 뒤에서 다시 문제가 된다.
2. 부호를 그래프로 바꾸는 순간
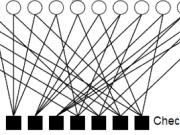
선형 부호를 디코딩한다는 것은 결국 연립방정식을 푸는 일이다. 패리티 검사 행렬 H가 있고, 받은 신호 y가 있다. Hx = 0을 만족하는 가장 그럴듯한 x를 찾으면 된다. 문제는 부호 길이가 조금만 길어져도 경우의 수가 폭발한다는 것. 그래서 실무는 행렬을 그래프로 다시 그린다. 행이 검사 노드, 열이 비트 노드가 되고, 1이 있는 자리에 선을 긋는다. 이것이 태너 그래프(Tanner graph)다.
LDPC 부호의 이분 그래프(태너 그래프). 위쪽 원이 비트 노드, 아래쪽 사각형이 검사 노드다 — Fostertaz, CC BY-SA 3.0 (Wikimedia Commons)
그래프 위에서는 계산이 아니라 소문이 돈다. 각 비트 노드가 자기 채널 관측값과 이웃 검사 노드들이 보낸 의견을 합쳐 로그 우도비(LLR)를 만들고, 검사 노드는 연결된 비트들의 부호를 곱해 짝이 맞는지 확인한다. 이 짝 맞추기를 수십 번 반복하면 대개 답이 나온다. 이 반복이 신념전파, BP다. 논문은 이 절차를 신경망으로 펼쳐 놓은 선행 연구, 즉 반복마다 학습 가능한 가중치를 넣은 신경 BP를 출발점으로 삼는다.
3. 변수 노드 한 층을 세 층으로 쪼갠다
GBPNet의 변형은 한 군데다. 한 번의 디코딩 반복 안에서 변수 노드 갱신을 한 층으로 처리하던 것을 K개의 연쇄된 하위 층으로 나눈다. 실험에서는 K=3으로 고정했다. 첫 하위 층은 채널값과 이전 반복의 검사 노드 메시지를 받고, 두 번째부터는 같은 반복 안에서 방금 만들어진 앞 하위 층의 메시지를 이웃별로 다시 모은다. 논문 표현대로면 변수 노드마다 작은 완전연결 블록이 생기는 셈이고, 이것이 반복 사이에만 정보가 흐르던 구조에 반복 안쪽의 정보 흐름을 더한다.
그다음 학습된 원소별 배율 층이 붙는다. 모든 메시지와 채널 메시지를 하나의 벡터로 세워 두고, 자리마다 다른 배율을 곱한다. 파라미터 수는 배율 층이 간선 수 E개, 각 변수 하위 층이 Σd²개(변수 노드 차수의 제곱합)다. 논문은 전체 파라미터를 한 층당 Σd²×K + E로 정리한다. 부호 길이의 제곱이 아니라 차수의 제곱에 비례한다는 점이 이 구조를 긴 부호로 확장할 여지를 남기는 대목이다.
4. 반직관적 결론 — 표현력을 늘렸는데 대칭이 깨지지 않는다
여기서 예상 밖의 지점이 나온다. 신경망 디코더를 만들 때 가장 귀찮은 것은 학습 데이터다. 부호어는 2^k개 있고, 모든 부호어에 대해 학습하려면 경우의 수가 감당이 안 된다. 그런데 메시지 전달이 특정 대칭 조건을 만족하면, 전부 0인 부호어 하나로만 학습해도 모든 부호어에서 같은 오류 확률이 나온다. 문제는 층을 늘리고 배율을 학습시키면 이 대칭이 깨질 것 같다는 의심이다. 표현력과 대칭은 보통 맞바꾸는 관계니까.
LDPC 디코딩의 반복 흐름: 채널 → 초기화 → 검사 노드 갱신 → 비트 노드 갱신 → 종료 판정 — Fostertaz, CC BY-SA 3.0 (Wikimedia Commons)
논문은 이 의심을 두 개의 보조정리로 닫는다. 변수 쪽 사상은 편향항이 없고 tanh와 학습된 배율의 합성이라 홀함수이며, 따라서 입력 전체의 부호를 뒤집으면 출력도 뒤집힌다. 검사 노드 갱신은 메시지들의 곱에 arctanh를 취하는 형태라 각 입력의 부호를 뒤집으면 전체 부호가 곱으로 빠져나온다. 두 조건이 성립하면 부호어에 무관한 오류 확률이 보장된다는 것이 선행 연구의 결과이고, 논문은 그것을 인용해 자기 구조가 그 조건을 지킨다고 주장한다. 표현력을 늘린 대가로 대칭을 잃는 대신, 대칭을 유지한 채 표현력만 늘리는 경로를 찾은 셈이다.
5. 훈련법 두 가지 — 높은 잡음에서 배우고, 한 번에 한 반복씩
실험 조건은 이렇다. 전부 0인 부호어를 BPSK로 변조해 가산성 백색 가우시안 잡음(AWGN) 채널에 통과시키고, 학습 표본 5×10⁷개를 쓴다. 옵티마이저는 Adam, 학습률 10⁻⁴, 배치 200, 손실은 선행 신경 BP의 교차엔트로피 다중 손실이다. 테스트는 각 SNR에서 최소 500 프레임 오류가 관측될 때까지 무작위 부호어로 돌린다.
첫 번째 전략은 높은 SNR 학습이다. 표본을 4~10dB 구간에서 만들고, 평가는 부호에 따라 1~8dB 또는 1~6dB에서 한다. 쉬운 문제로 먼저 감을 잡고 어려운 구간으로 넘어가는 순서를 뒤집은 것이다. 두 번째는 점진적 학습이다. 반복 1회짜리 네트워크로 시작해, 단계마다 새 반복을 무작위로 초기화해 붙이고 이미 학습된 앞 반복의 가중치는 유지한 채 전체를 200 에폭씩 함께 학습한다. 깊은 망을 한 번에 세우면 초기값 운에 좌우되기 쉬운데, 그 위험을 단계별로 나눠 흡수하는 방식이다. 논문은 두 전략이 각각 오류율을 더 낮춘다고 보고한다.
6. 경쟁 가설 — 트랜스포머는 왜 졌다고 주장되는가
최근 몇 년의 신경 디코더 흐름은 다른 방향이었다. 수신열을 신드롬 표현으로 바꾸고 트랜스포머의 자기집중으로 전역 상관관계를 한꺼번에 보는 쪽이다. ECCT, CrossMPT가 그 계열이고, 논문의 비교표에 나란히 놓인다. 이들의 논리는 명확하다. 메시지 전달은 이웃끼리만 이야기하니 정보가 퍼지는 속도가 그래프의 지름에 묶이고, 집중(attention)은 그 제약을 한 번에 넘는다는 것이다.
GBPNet의 반론은 반대 방향에서 온다. 전역 집중을 얻는 대신 태너 그래프라는 구조적 사전지식을 버리는 비용이 크다는 것. 그래서 구조는 그대로 두고 변수 노드 내부만 조금 넓히면, 집중 없이도 상당 부분을 따라잡거나 앞선다는 것이 논문의 주장이다. 다만 반론도 가능하다. 논문은 트랜스포머 계열 성능으로 "보고된 최고 결과"를 인용했지, 같은 학습 예산과 같은 표본 수로 다시 학습해 비교하지는 않았다고 밝힌다. 학습 표본 5×10⁷개는 결코 작지 않지만, 비교 대상이 각자 자기 조건에서 얻은 최고치라면 표의 격차 일부는 구조 차이가 아니라 실험 조건 차이일 수 있다. 저자도 이 점을 숨기지 않고 비교 방법을 명시했다.
7. 논문이 스스로 인정한 한계
결론 절이 인정하는 것은 짧다. 다음 과제로 신경망 구조 탐색을 들며, 반복마다 변수 하위 층 수를 몇 개로 둘지와 전체 디코딩 반복 수를 자동으로 정하겠다는 것이다. 다시 말해 K=3, 반복 2~5회라는 값은 이번 실험에서 사람이 고른 상수이고, 왜 그 값이 최적인지는 아직 답이 없다. K를 1, 2, 3으로 늘리면 오류율이 계속 좋아진다는 관찰만 있다. 그리고 표에 실린 부호는 길이 63에서 128까지다. 휴대전화와 위성 통신에서 쓰는 긴 LDPC와 비교해 이득이 유지되는지는 이 논문의 범위 밖이다.
논문에 없는 것도 짚어 둘 만하다. 복잡도, 지연시간, 전력당 처리량 같은 실무 지표는 표에 없다. 변수 하위 층을 세 겹으로 쌓고 배율 층까지 붙였으니 반복 한 번의 연산량은 늘었을 것이고, 그 대가를 지불하고도 남는 이득인지는 별도로 따져야 한다. 기존 BP가 하드웨어에서 극도로 값싸게 도는 것을 생각하면, 196배라는 숫자는 "같은 비용에서 196배"가 아니라 "같은 반복 수에서 196배"로 읽어야 정확하다. 이 구분을 놓치면 표가 실제보다 큰 약속처럼 보인다.
그래서 남는 질문은 이것이다. 우리는 오류를 줄이는 일과 계산을 줄이는 일 중 무엇을 더 비싸게 여기는가. 스마트폰 배터리로 도는 모뎀이라면 후자이고, 지상국에서 몇 밀리초를 더 써도 되는 위성 링크라면 전자다. 이 논문은 어느 쪽을 겨냥한 것도 아니고, 두 축을 함께 놓은 표도 제시하지 않는다. 독자라면 어느 쪽을 먼저 보고 싶은가.
8. 참고 자료
S. Malek, "Learning to Decode Linear Codes with Generalized Belief Propagation Network", arXiv:2611.06874v1 [cs.AI], 2026-11-04. https://arxiv.org/abs/2611.06874
이미지: Wikimedia Commons, Fostertaz, CC BY-SA 3.0 — Lpdc bipartite graph, Lpdc decode flow.
댓글2
-
빗방울
2026.11.06 10:37
Polar에서 1,500배, BCH에서는 19배라니 같은 구조인데 폭이 이렇게 벌어지는 게 제일 궁금하네요. 저는 부호의 차수 분포 차이일 거라고 짐작하는데, 혹시 논문에 부호별로 따로 학습시킨다는 언급이 있나요? K=3이 고정값이라 최적이라는 보장이 없다는 부분도 흥미롭고요. -
빗방울
2026.11.06 11:59
파라미터가 부호 길이가 아니라 변수 노드 차수의 제곱합에 비례하는 대목이 제일 흥미롭네요. 표에 실린 부호가 63~128비트뿐이라 아직은 작은 실험이지만, 파라미터가 부호 길이의 제곱이 아니라는 점만 해도 긴 LDPC로 넘어갈 여지는 남아 있다고 느꼈어요. 다만 차수가 큰 부호에서는 Σd²가 결국 꽤 커질 텐데, 그때도 학습이 잘 될지는 궁금하네요.
모든 이야기2092
가벼운 안부부터 깊은 생각까지, 함께 나눠요.