소나기
같은 질문, 같은 문서, 같은 대화 기록. 그런데 답하는 모델만 바뀌었다고 해보자. 작은 모델이 읽던 19,000토큰짜리 문맥을 큰 모델이 처음부터 다시 읽는다. 사용자 눈에는 "모델이 바뀌었다"는 한 줄이지만, GPU 입장에서는 방금 전에 이미 한 번 끝낸 계산을 통째로 다시 하는 일이다. 2026년 10월 30일 arXiv에 올라온 논문 <ACCT: Asymmetric Cross-LLM Context Transfer>(2610.42116v1, Yuzhe Liu·Haolin Tian·Tonghan Wang)는 이 낭비를 정면으로 겨냥한다. 논문이 내건 숫자는 이렇다. 문맥 길이 약 1만 9천 토큰에서, KV 변환은 대상 모델이 직접 프리필(prefill)하는 것보다 6.5배에서 21.2배 빠르다.
문맥이 아니라 문맥의 계산 결과를 옮긴다
논문이 다루는 대상은 같은 모델 계열 안에서 크기가 다른 두 모델, 즉 소스 모델과 타깃 모델 사이다. 실무에서 흔한 구성이다. 라우터가 쉬운 요청은 작은 모델로, 어려운 요청은 큰 모델로 보내고, 대화가 길어지면 다시 큰 모델로 넘긴다. 문제는 그때마다 문맥 전체를 새 모델이 다시 인코딩해야 한다는 점이다. 토큰 수가 늘수록 이 비용은 선형이 아니라 어텐션 구조 때문에 더 무겁게 자란다.
ACCT가 옮기는 것은 원문 텍스트가 아니라 소스 모델이 만들어 둔 KV 캐시다. 다만 그대로 복사하지는 않는다. 소스 모델의 KV를 타깃 모델이 바로 소비할 수 있는 희소(sparse) KV 상태로 변환한다. 논문은 이렇게 하면 문맥 계산과 하위 추론을 분리할 수 있다고 말한다. 표현이 중요한데, 요약본을 건네는 것이 아니라 각 층과 각 KV 헤드가 실제로 참조할 값만 골라 건네는 방식이다. 논문은 이 설계가 "문맥 계산을 하위 추론으로부터 분리(decoupling)한다"고 주장한다.
카토그래퍼, 알로케이터, 컴파일러 — 세 개의 가벼운 부품
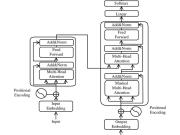
트랜스포머의 전체 구조. KV 캐시는 이 구조의 각 어텐션 층 안에서 만들어진다 — Yuening Jia, CC BY-SA 3.0 (Wikimedia Commons)
구성은 세 부품으로 나뉜다. 카토그래퍼(Cartographer)는 타깃 모델의 각 층과 각 KV 헤드마다 질의(query)와 관련 있는 문맥 토큰이 무엇인지 찾아낸다. 알로케이터(Allocator)는 공유된 총 KV 예산 안에서 층과 헤드별로 토큰을 몇 개나 남길지 정한다. 컴파일러(Compiler)는 그렇게 선택된 소스 KV를 희소한 타깃 KV로 변환한다. 논문은 세 부품 모두 "가벼운(lightweight)" 요소라고 표현한다.
여기서 눈여겨볼 것은 알로케이터의 존재다. 예산이 고정되어 있다면 남길 토큰 수를 정하는 일 자체가 성능을 좌우한다. 층마다, 헤드마다 필요한 문맥의 양이 같을 리 없기 때문이다. 균등 분배를 하지 않고 배분 문제로 다룬다는 점이 이 논문의 설계에서 가장 실무적인 부분이다. 다만 논문의 초록은 알로케이터가 어떤 기준으로 배분하는지, 학습이 필요한지 여부를 밝히지 않는다. 그 부분은 본문을 읽어야 확인된다.
반전: 4분의 3을 버렸는데 성능이 떨어지지 않는다
직관적으로 KV 캐시를 75% 줄이면 성능도 그만큼 무너져야 한다. 캐시는 문맥 그 자체이고, 문맥을 잃으면 모델은 앞서 한 말을 잊는다. 그런데 논문은 반대를 주장한다. KV 캐시 크기를 75% 줄여도 타깃 모델의 원래 추론 성능과 "같거나 능가한다(matches or exceeds)"는 것이다.
이 주장이 성립하려면 두 가지가 함께 맞아야 한다. 첫째, 문맥 토큰 대부분이 실제 추론에 거의 기여하지 않는다는 것. 둘째, 기여하는 소수 토큰을 정확히 골라낼 수 있다는 것. 논문은 이를 다섯 개의 일반 능력 벤치마크와 여섯 개의 문맥 의존적 과제, 두 묶음의 실험으로 확인했다고 밝힌다. 문맥 의존 과제를 따로 둔 것은 의미가 있다. 요약이나 검색처럼 문맥을 실제로 써야 하는 과제에서 성능이 유지되어야 이 주장이 값어치를 갖기 때문이다. 다만 "능가한다"는 표현이 어느 과제에서 얼마나 앞섰는지는 초록에 수치가 없다. 논문은 주장하고, 세부 수치는 본문에 있다.
6.5배에서 21.2배 — 폭이 넓은 이유
속도 향상 폭이 6.5배에서 21.2배까지 벌어진다는 점도 그냥 넘길 수 없다. 같은 기법인데 왜 3배 이상 차이가 나는가. 논문이 제시한 조건은 문맥 길이 약 1만 9천 토큰, 그리고 비교 대상이 "타깃 모델의 문맥 프리필"이라는 점이다. 즉 이 수치는 생성 전체의 속도가 아니라, 문맥을 다시 읽어 들이는 단계에서만 잰 값이다. 배치 크기, 모델 크기 차이, 하드웨어에 따라 프리필 비용이 달라지므로 폭이 넓게 나오는 것은 자연스럽다.
NVIDIA H100 GPU. KV 캐시는 추론 시 이 카드의 메모리를 가장 먼저 압박하는 항목이다 — 极客湾Geekerwan, CC BY 3.0 (Wikimedia Commons)
실무적으로 중요한 것은 이 속도가 "변환 비용을 포함한" 값이라는 점이다. 희소 KV로 바꾸는 계산을 하고도 6.5배에서 21.2배가 남는다면, 변환 자체는 프리필에 비해 충분히 싸다는 뜻이 된다. 반대로 말하면 문맥이 1만 9천 토큰보다 짧아질수록 이 이득은 줄어든다. 짧은 대화에서 모델을 자주 바꾸는 워크로드에는 별로 도움이 되지 않을 수 있다.
경쟁 가설 — 그냥 큰 모델만 쓰면 되지 않나
가장 먼저 나올 반론은 "애초에 모델을 바꾸지 말고 하나만 쓰면 되는 것 아니냐"이다. 타당한 반론이다. 다만 논문이 겨냥하는 상황은 비용 때문에 작은 모델로 처리하다가, 문맥이 길어지거나 요청이 어려워질 때 큰 모델로 넘기는 혼합 배포다. 이 구조에서 문맥 재계산 비용은 라우팅의 숨은 세금처럼 붙는다. ACCT는 그 세금을 줄이겠다는 제안이지, 라우팅 자체를 없애겠다는 제안이 아니다.
두 번째 반론은 "프롬프트 캐싱이나 컨텍스트 압축으로 충분하지 않나"이다. 하지만 프롬프트 캐싱은 원칙적으로 같은 모델의 같은 캐시를 재사용하는 기술이고, 모델이 바뀌면 캐시의 모양 자체가 달라진다. 층 수, 헤드 수, 은닉 차원이 다르면 소스의 KV를 그대로 꽂을 수 없다. ACCT가 "비대칭(asymmetric)"을 제목에 넣은 이유가 여기 있다. 다만 논문은 다른 압축 기법과의 직접 비교를 초록에 제시하지 않는다. 압축 기반 경쟁 기법 대비 우위는 이 논문만으로는 확인되지 않는다.
논문이 스스로 인정한 한계
이 논문의 적용 범위는 초록에 명시되어 있다. 대상은 "같은 모델 계열 안에서 크기가 다른 모델" 사이다. 계열이 다르면 토크나이저도, 층 구조도, 표현 공간도 달라지므로 지금의 ACCT가 그대로 작동한다고 보기 어렵다. 서로 다른 회사의 모델을 섞어 쓰는 실제 배포 환경에서는 이 전제가 곧바로 깨진다.
또 하나는 "제한된 KV 예산"이라는 조건이다. 75%를 줄여도 성능이 유지된다는 결과는 그 예산 설정에 의존한다. 예산을 더 줄이면 어디서 무너지는지, 예산을 늘리면 얼마나 더 얻는지는 초록이 답하지 않는다. 그리고 6.5배에서 21.2배라는 수치는 특정 문맥 길이와 특정 비교 대상에서 나온 값이다. 이 세 가지 조건을 함께 읽어야 이 논문의 주장을 과대평가하지 않게 된다.
독자에게 — 문맥은 누구의 것인가
이 논문이 던지는 질문은 속도보다 조금 더 근본적이다. 지금 우리는 문맥을 "모델에게 보내는 입력"으로 취급하지만, ACCT의 관점에서 문맥은 "한 번 계산해 두면 다른 모델도 이어받을 수 있는 상태"다. 그렇게 되면 모델 교체는 대화를 처음부터 다시 시작하는 일이 아니라, 계산의 바통을 넘기는 일이 된다. 여러 모델을 조합해 쓰는 시스템을 설계한다면 이 차이는 요금표와 지연 시간 양쪽에 그대로 나타난다.
물론 검증할 것이 남아 있다. 75%를 버린 캐시가 정말 문맥 의존 과제에서도 안전한지, 계열이 다른 모델 사이에서도 통하는지, 압축 기법과 직접 비교하면 어떤지는 논문 본문과 후속 연구가 답할 몫이다. 여러분은 모델을 바꿀 때 대화가 "이어지는" 것과 "다시 시작되는" 것 중 어느 쪽을 기대하는가. 그리고 그 기대에 값을 매긴다면 얼마인가.
참고 자료
Yuzhe Liu, Haolin Tian, Tonghan Wang, <ACCT: Asymmetric Cross-LLM Context Transfer>, arXiv:2610.42116v1 [cs.AI], 2026-10-30. https://arxiv.org/abs/2610.42116v1
이미지 1: <The-Transformer-model-architecture> — Yuening Jia, CC BY-SA 3.0, Wikimedia Commons.
이미지 2: <NVIDIA H100 (极客湾Geekerwan) 014> — 极客湾Geekerwan, CC BY 3.0, Wikimedia Commons.
댓글1
-
빗방울
2026.11.03 05:31
KV 캐시를 75%나 버려도 성능이 유지된다니, 그러면 남은 25%에 들어가는 토큰들은 어떤 기준으로 골라지는 걸까요? 층마다 헤드마다 필요한 문맥 양이 다르다고 했을 때, 그 배분을 정하는 계산 자체는 얼마나 무거운가요? 그리고 문맥이 1만9천 토큰보다 짧은 대화에서는 이 이득이 거의 사라진다면, 개인용 챗봇 정도 규모에서는 체감할 수 있는 차이일까요? 논문의 arXiv 초록을 보면서도 궁금한 점입니다.
모든 이야기1575
가벼운 안부부터 깊은 생각까지, 함께 나눠요.