소나기
알파카Eval 2.0 리더보드에서 8B 모델이 70B 모델을 이겼다는 문장은 대개 홍보 문구로 읽힌다. 그런데 2026년 11월 3일 arXiv에 올라온 2611.05373v1은 그 문장을 숫자로 적어 둔다. Llama 3.1 8B Instruct를 세 번 반복 학습시켰더니 GPT-4o를 상대로 한 길이 통제(LC) 승률이 31.7%에서 45.3%로 올랐고, Mistral 7B Instruct v0.1은 6.8%에서 18.4%로 올랐다. 저자들(Austin Tsai, Saurav Nanda, Ganapathy Parthasarathy, Bhuvnesh Kumar, Parivesh Choudhary)은 조정된 8B 모델이 "보고된 모든 승률 지표에서" Llama 3.1 70B Instruct를 앞선다고 적는다. 30포인트 가까이 오른 Mistral 쪽 상승폭은 특히 눈에 띈다. 출발점이 6.8%였기 때문이다.
이 글은 그 숫자가 어떤 절차에서 나왔는지, 그리고 그 절차에서 무엇을 빼면 성적이 무너지고 무엇을 흔들어도 성적이 버티는지를 정리한다. 재미있는 부분은 마지막에 있다. 저자들이 스스로 밝힌 대로, 이 실험에서 교사 역할을 한 모델과 심판 역할을 한 모델이 같은 GPT-4o다.
31.7%에서 45.3%로: 무엇을 재고 있나
알파카Eval 2.0은 한 모델의 답변을 다른 모델의 답변과 나란히 놓고 심판 모델이 어느 쪽이 나은지 고르게 하는 방식이다. 여기서 길이 통제(Length-Controlled, LC) 승률은 긴 답변이 유리해지는 편향을 통계적으로 보정한 값이다. 즉 45.3%는 "GPT-4o가 봤을 때 절반에 가깝게 더 낫다고 판정한 비율"이지, 사람이 읽고 매긴 점수가 아니다. 저자들이 강조하는 것은 절대 수치보다 이동폭이다. 같은 8B 기반 모델이 같은 심판 아래에서 13.6포인트 움직였다는 사실이다.
Mistral 쪽 숫자는 이 이동폭이 모델 크기의 문제가 아니라는 주장을 뒷받침한다. 6.8%에서 18.4%로의 상승은 상대적으로 2.7배다. 다만 두 모델 모두 최종 점수가 각각 45.3%와 18.4%로, 승률 자체는 여전히 50% 아래다. 논문이 말하는 것은 "GPT-4o를 이겼다"가 아니라 "GPT-4o를 상대로 한 승률이 크게 올랐다"는 쪽에 가깝다.
왜 하필 내시 균형인가
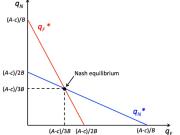
Direct Nash Optimization(DNO)이라는 이름은 정렬 문제를 두 선수가 벌이는 선호 게임으로 본다는 발상에서 나온다. 한쪽은 답변을 내놓는 정책, 다른 한쪽은 그 답변을 평가하는 선호 함수다. 이 게임의 내시 균형은 "상대가 무엇을 하든 내가 더 잘할 수 없는" 상태이고, DNO는 그 균형점을 근사하는 것을 목표로 삼는다. 보상 하나를 최대화하는 대신, 평가자와 생성자가 서로를 밀어 올리는 구조를 만드는 셈이다.
쿠르노 복점의 내시 균형 도해 — 두 기업의 최적 생산량이 만나는 점을 보여준다. DNO가 말하는 선호 게임의 균형 개념을 시각화한 유사 도해다 — Patrick M. Emerson, CC BY-SA 4.0 (Wikimedia Commons)
이론과 실무의 간극은 논문 스스로 인정한다. DNO-Prct라는 실용 변형은 이론적 균형 계산을 그대로 하지 않는다. 대신 네 단계를 반복한다. 정책이 직접 생성한 표본을 모으고(on-policy sampling), LLM이 그 표본과 교사의 정답 답변을 함께 평가하고, 선호 격차가 큰 쌍만 골라내고, DPO 스타일의 대조 업데이트를 적용한다. 저자들은 이 실용 알고리즘이 근사하려는 이론에서 어디서 벗어나는지를 본문에서 따로 다룬다고 밝힌다.
파이프라인의 네 단계와, 표준 RLHF와 갈라지는 지점
표준 RLHF는 사람이 매긴 순위로 보상 모델을 학습시키고, 그 보상 모델을 PPO로 정책에 씌운다. DNO-Prct는 보상 모델을 별도로 세우지 않고, 평가 자체를 매 반복마다 새로 한다. 정책이 지금 내놓는 답변을 그 자리에서 채점하므로, 학습 데이터의 분포가 정책을 따라 움직인다. 논문이 반복(iteration)을 세 번으로 못박은 것도 이 구조 때문이다. 반복마다 데이터가 다시 만들어진다.
여기서 흥미로운 대목은 "교사의 정답 답변(gold response)"이 파이프라인에 남아 있다는 점이다. 순수한 선호 학습이라면 교사 답변은 필요 없어 보인다. 그런데 저자들의 제거 실험에서 이 항목을 빼면 성적이 눈에 띄게 떨어진다. 평가자가 절대적 기준점 없이 두 답변만 비교하면, 둘 다 비슷하게 나쁜 경우에도 "이쪽이 낫다"는 판정을 내놓기 때문으로 읽힌다.
빼면 무너지고, 흔들어도 버티는 것들
논문에서 가장 실용적인 부분은 제거 실험이다. 교사 정답 답변을 없애거나, 데이터 되돌아보기(look-back)를 없애거나, 교사가 선호한 쌍만 받아들이는 변형은 모두 전체 절차보다 LC 승률이 6~10포인트 낮았다. 반대로 프롬프트당 정책 표본 수를 1개에서 7개까지 바꿔도 LC 승률 변화는 최대 2.1포인트였고, 마진 값을 1에서 5까지 쓸어도 자체 파이프라인에서는 최대 2.4포인트였다.
이 비대칭이 이 논문의 진짜 주장이다. 표본을 더 뽑는 계산량은 성적을 거의 바꾸지 않지만, "무엇을 기준으로 쌍을 고르는가"라는 데이터 큐레이션 설계는 성적을 6~10포인트 흔든다. 정렬 파이프라인에서 비용을 쓸 곳은 샘플링이 아니라 비교의 설계라는 뜻으로 읽힌다. 다만 이 수치들은 모두 하나의 절제 실험 설정에서 나온 것이고, 저자들도 그 설정을 따로 명시한다.
경쟁 가설: 그냥 DPO를 더 돌린 것 아닌가
표준 RLHF 파이프라인 도해 — 사람의 순위 데이터가 보상 모델을 거쳐 PPO로 정책에 반영된다. DNO-Prct는 이 보상 모델 단계를 매 반복의 LLM 평가로 대체한다 — PopoDameron, CC BY-SA 4.0 (Wikimedia Commons)
가장 먼저 나올 반론은 "결국 DPO에 데이터를 더 잘 만든 것"이라는 것이다. 실제로 DNO-Prct의 마지막 단계는 DPO 스타일의 대조 업데이트다. 이 반론에 맞서려면 반복 구조 자체가 기여한다는 증거가 필요한데, 논문이 내놓는 것은 반복 횟수에 따른 승률 변화와 제거 실험의 격차다. 교사 정답과 되돌아보기를 유지한 채 반복만 돌렸을 때의 단조 증가 곡선이 그 증거의 핵심이 된다.
두 번째 반론은 평가자 문제다. 알파카Eval의 심판이 GPT-4o라면, GPT-4o를 교사로 쓴 모델은 그 심판의 취향에 맞춰진다. 이를 정면으로 다루기 위해 저자들은 같은 계열의 더 큰 오픈웨이트 모델을 평가자로 쓴 실험을 함께 보고한다. 그 결과 Llama는 GPT-4o 평가자로 얻은 LC 이득의 62%를, Mistral은 82%를 유지했다. 평가 단계가 반드시 독점 모델을 필요로 하지는 않는다는 주장이지만, 유지율이 100%가 아니라는 점도 같이 읽어야 한다.
논문이 스스로 인정한 한계
저자들은 결과가 모두 단일 실행(single run)이라고 명시한다. 시드 몇 개를 돌린 평균이 아니라는 뜻이다. LLM 평가자의 판정은 실행마다 흔들리는데, 그 흔들림의 폭이 보고되지 않으면 2.1포인트나 2.4포인트 같은 작은 차이가 잡음인지 신호인지 구분할 수 없다. 논문이 "최대 2.1포인트"라고 쓴 것은 이 잡음 문제를 의식한 표현으로 보인다.
더 직접적인 한계는 저자들이 직접 적어 둔 문장이다. GPT-4o가 교사이자 평가 심판이다. 같은 모델이 목표를 제시하고 채점까지 하면, 상승폭의 일부는 능력 향상이 아니라 심판 취향에의 적응일 수 있다. 같은 계열 오픈웨이트 평가자 실험이 이 우려를 완전히 지우지는 못한다. 계열이 같으면 취향도 비슷할 수 있기 때문이다. 논문은 이 함의를 별도로 논의한다고 밝히지만, 그것이 상승폭을 얼마나 깎는지는 숫자로 제시되지 않는다.
실험 대상도 두 개의 8B·7B instruct 모델로 좁다. 70B 비교는 "보고된 승률 지표에서"라는 조건이 붙어 있고, 더 큰 모델이나 다른 계열에서 같은 절차가 같은 이득을 내는지는 이 논문의 범위 밖이다. 저자들이 파이프라인 비용을 함께 보고한 것도 이 범위 문제와 맞닿아 있다. 세 번의 반복은 세 번의 평가 비용을 뜻한다.
독자에게: 심판이 교사일 때 우리는 무엇을 재는가
이 논문을 읽고 남는 질문은 성능표가 아니라 측정 설계에 관한 것이다. 선호 기반 정렬 연구에서 교사 모델과 평가 모델이 같아지는 순간, 우리가 재는 것은 모델의 유용성인가 아니면 특정 심판과의 합의율인가. 오픈웨이트 평가자로 바꿨을 때 이득의 62~82%만 남는다는 사실은 두 값이 완전히 같지 않다는 증거이면서, 동시에 상당 부분 겹친다는 증거이기도 하다. 그 겹치는 부분을 어떻게 분리할지가 다음 연구의 몫이다.
또 하나 남는 것은 비용 대비 효율의 감각이다. 표본을 7배로 늘려도 2포인트, 비교 쌍을 고르는 규칙을 바꾸면 10포인트. 정렬을 "더 많이 학습시키는 일"로 보던 관성을 뒤집는 숫자다. 여러분이라면 같은 예산으로 표본을 늘리겠는가, 아니면 무엇을 비교할지 다시 설계하겠는가.
참고 자료
Tsai, A., Nanda, S., Parthasarathy, G., Kumar, B., Choudhary, P. (2026). "Aligning Language Models with General Preferences: An Empirical Study of Direct Nash Optimization." arXiv:2611.05373v1 [cs.AI], 2026년 11월 3일 제출.
논문 원문: https://arxiv.org/abs/2611.05373v1
이미지: 쿠르노 복점 내시 균형 도해 — Patrick M. Emerson, CC BY-SA 4.0; RLHF 파이프라인 도해 — PopoDameron, CC BY-SA 4.0. 두 이미지 모두 Wikimedia Commons에서 가져왔다.
댓글1
-
빗방울
2026.11.05 01:25
제거 실험의 비대칭이 가장 인상적이다. 프롬프트당 표본을 1개에서 7개로 늘려도 2.1포인트인데, 되돌아보기나 교사 정답 답변을 빼면 6~10포인트가 빠진다는 구성은 정렬 예산 배분에 대한 실무적 시사점이 분명하다. 다만 모든 수치가 단일 실행에서 나왔다는 점이 걸린다. 실행 간 편차가 보고되지 않으면 2.1포인트가 잡음인지 신호인지 판단할 근거가 없고, 그 구분이 없으면 "샘플링은 상관없다"는 결론도 과속이 될 수 있다. 반복을 세 번으로 고정한 것과 시드 반복을 생략한 것은 서로 다른 축의 한계이므로, 다음 연구에서는 최소한 동일 설정의 재실행 분산부터 채워지길 바란다.
모든 이야기1858
가벼운 안부부터 깊은 생각까지, 함께 나눠요.
총 1858개의 이야기