소나기
1000만 토큰. 소설 20권을 한 번에 넣고 '3장에 나온 인물의 직업이 뭐였지'라고 묻는 상황을 생각해 보자. 지금의 어텐션은 이 질문 하나를 처리하기 위해 1000만 개의 키(key)를 전부 상대한다. 2026년 10월 30일 arXiv에 올라온 논문 「Subquadratic Attention with a Hierarchical Tree-Structured Indexer」는 이 지점에서 숫자 하나를 먼저 꺼낸다. 문맥이 100만 토큰에 가까워지면, 스파스 어텐션 계열 모델에서 해당 층 실행 시간의 60~90%가 '무엇을 볼지 고르는 인덱싱'에 쓰인다는 것이다. 덜 보겠다고 만들어 놓은 장치가 시간을 다 먹는 셈이다.
문제는 '고르는 일'이 다시 이차가 된다는 것
논문이 정리하는 기존 해법의 두 갈래는 이렇다. 하나는 슬라이딩 윈도나 선형 어텐션, 상태공간 모델처럼 KV 캐시를 고정 크기 상태로 바꾸는 방식이다. 계산은 싸지지만 상태가 포화되면서 긴 문맥에서 성능이 떨어진다. 다른 하나는 스파스 어텐션이다. 질문마다 관련 있는 키 일부만 골라 보자는 발상인데, 고르는 인덱서 자체가 문맥 길이에 대해 다시 이차로 커지면 아낀 만큼을 그대로 되돌려 준다. 논문의 표현을 빌리면 '상수배 빨라질 뿐'이다.
그래서 논문은 두 가지 조건을 먼저 세운다. 첫째, 희소성은 질문마다 달라야 한다(쿼리 의존적 희소성). 둘째, 활성 상태의 크기는 늘어나되 선형보다 느리게 늘어야 한다(성장하지만 준선형인 상태). 고정 크기 상태는 언젠가 반드시 포화되고, 전체 KV 캐시를 유지하는 완전 어텐션은 표현력은 최대지만 정보가 극도로 중복된다. 이 두 극단 사이의 어딘가를 겨냥하겠다는 것이 출발점이다.
먼저 확인한 것: 언어 데이터는 이미 압축 가능하다
논문은 아키텍처를 만들기 전에 측정부터 한다. 긴 소설 데이터에서 전역 어텐션 층들의 'top-p 집합' 크기를 재는 것이다. top-p 집합은 어텐션 확률을 큰 순서로 더해 합이 p를 넘는 최소 키 묶음, 즉 어텐션이 실제로 보고 있는 진짜 시야를 잡아내는 필터다. 결과는 p가 1보다 작은 모든 구간에서 이 집합의 크기가 문맥 길이에 대해 준선형 멱법칙으로 자란다는 것이었다. 문맥이 길어질수록 오히려 더 압축이 잘 된다는 뜻이다.
여기서 논문이 덧붙이는 해석이 흥미롭다. 멱법칙은 보통 스케일 불변성, 즉 '어느 층위에서 보든 같은 통계'를 뜻한다. 토큰을 기하급수적으로 묶어 요약해도 그 요약의 통계가 비슷하게 유지된다면, 그 요약을 가지고 재귀적으로 라우팅할 수 있다는 것이다. 다만 저자들은 이 멱법칙이 항상 성립하지는 않는다고 밝힌다. 부분 RoPE를 쓰는 Qwen3.6-35B-A3B에서는 견고하게 나타났지만, NoPE를 쓰는 Nemotron-3.5-Lightning-30B-A3B에서는 그만큼 깔끔하게 나오지 않았다.
그런데 희소하다고 버릴 수는 없다
여기서 반직관적인 측정이 하나 나온다. 질문 하나의 어텐션이 희소하다고 해서 캐시를 영구히 버려도 된다는 뜻은 아니다. 논문은 26만 1548 토큰짜리 소설에서 최근 W개 질문의 top-p 집합을 모두 합친 합집합이 앞쪽 문맥을 얼마나 덮는지 계산한다. W가 커지면 이 합집합은 결국 캐시 전체를 덮는다. 어떤 질문에게 무시당한 키가 다음 질문에게는 결정적일 수 있다는 뜻이고, 그래서 이 논문은 KV 캐시를 전부 보관한 채 질문마다 다른 부분집합을 꺼내 쓰는 쪽을 택한다.
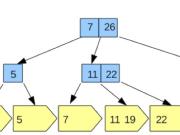
인덱스 집합(파란 노드)이 시퀀스 집합(노란 잎)을 가리키는 B+ 트리 구조. ZHA가 만드는 나무도 같은 발상으로, 위층의 요약 노드가 아래층 키 묶음을 대표하고 질문은 위에서 아래로 내려가며 후보를 좁힌다 — Aexpedito, CC BY-SA 3.0 (Wikimedia Commons)
그러면 남는 문제는 하나다. 전체를 저장하되, 찾는 일만 준선형으로 끝내야 한다. 논문의 답은 연속된 키 묶음을 요약한 노드를 기하급수적으로 쌓은 나무다. 위층의 거친 요약이 질문을 유망한 구역으로 안내하고, 그 구역만 더 높은 해상도로 다시 채점한다. 관련 없다고 판정된 묶음은 개별 키를 들여다볼 필요 없이 통째로 버린다. 비교 횟수를 줄이는 방식이 '더 빠른 비교'가 아니라 '비교할 대상의 수'를 줄이는 데서 나온다는 점이 핵심이다.
나무를 세우는 데 학습되는 것은 질문 16개뿐
구현은 의외로 절제되어 있다. 청크 크기 C, 깊이 L이면 최상위 노드 하나가 C의 L승 개 원본 키를 대표한다. 각 노드는 학습된 '참조 질의'들에 대한 어텐션 가중합으로 압축되고, 청크의 로그 어텐션 질량은 질의에 대한 볼록함수이므로 참조 질의 지점에서의 접선들로 조각별 선형 근사를 만든다. 미래의 질문은 그 접선들 중 최댓값을 취해 청크의 질량을 추정한다. 학습되는 것은 이 참조 질의 집합뿐이다.
그래서 기존 모델에 얹는 비용이 작다. 백본은 얼려 두고, 청크 확률이 실제 어텐션 분포와 맞도록 KL 발산을 최소화하는 짧은 워밍업만 돌린다. 실험에서는 32K 문맥으로 40억 토큰을 학습했다. 참조 질의 16개, KV 헤드마다 나무 하나를 두는 설정에서 파라미터 증가는 34.66B 모델 기준 8만 1920개, 약 0.00024%다. 나무 유지 비용도 디코드 단계에 분산되면 1% 이하로 모델링된다.
결과: 캐시의 1~6%만 보면서 96.0%가 93.3%로
Qwen3.6-35B-A3B를 ZHA로 변환한 결과는 이렇다. 깊은 나무(C4, 6층)와 넓은 나무(C256, 1층) 모두 추론, 에이전트 코딩, 장문 벤치마크에서 dense 기준과 오차 범위 안에 들었다. 유일한 예외가 RULER-13으로, 깊은 나무가 93.3% 대 dense 96.0%였다. 3%포인트 떨어진 대신 원본 KV 캐시의 1~6%만 상대한 것이다. 같은 백본에 Minimax Sparse Attention을 400억 토큰으로 학습시킨 비교에서는, LongBench v2에서 깊은 ZHA가 비슷한 1.1%의 키를 보면서 14점 앞섰다. 상대는 ZHA보다 10배 많은 토큰으로 학습됐다.
여기서 눈에 띄는 것은 작업에 따라 희소성이 달라진다는 점이다. 64K 문맥에서 어텐션 질량의 90%가 들어 있는 16키 청크 비율의 중앙값은 RULER에서 2.3%, SWE-bench Verified에서 11.7%, 소설에서 15.0%였다. 합성 채우기 텍스트에서는 좁게 찾고, 코드와 도구 출력에서는 넓게 훑어야 한다. 고정 예산 top-K는 이 차이를 맞출 수 없어 늘 넉넉하게 잡거나 늘 모자라게 잡아야 하지만, top-p는 질문마다 예산을 스스로 정한다.
계산이 실제로 언제 빨라지는지는 별도로 모델링한다. 논문은 최적화 커널을 공개하지 않고, FLOPs와 메모리 대역폭, 워커 웨이브를 함께 계산하는 roofline 모델로 지연 시간을 외삽한다. 경량 설정(R=1, C=8, p=0.75)에서 ZHA는 약 4만 8000 토큰에서 dense보다, 48만 토큰에서 MSA보다 빨라진다. 10억 토큰에서는 dense 대비 373~417배, MSA 대비 52~58배로 모델링되고, 그때 선택되는 깊이는 5층이다. 짧은 문맥에서 손해를 감수하고 아주 긴 문맥에서 이득을 보는 구조다.
반전: 나무를 깊게 만드는 쪽이 오히려 안전했다
이론적으로 깊은 나무는 위험해 보인다. 층마다 근사 오차가 쌓이고, 깊어질수록 라우팅이 틀릴 기회가 늘어나기 때문이다. 그런데 압축률을 C의 L승으로 고정하고 깊이만 바꾼 실험에서, 깊은 쪽이 같은 희소성에서 더 나은 검색 성능을 보였다. 28가지 기하 설정을 64K·128K·256K에서 훑은 뒤, 논문은 참조 질의 수 R, 청크 크기 C, 깊이 L, 임계값 p만으로 RULER 정확도를 예측하는 4-파라미터 모델을 만든다. 길이 하나를 통째로 빼고 학습해 나머지로 예측한 RMSE는 1.44%포인트, 256K 구간만 보면 1.65%포인트다.
왼쪽은 영역을 재귀적으로 네 갈래로 나눈 배열, 오른쪽은 그 분할을 대응시킨 트리. 압축률은 청크 크기 C의 깊이 L승으로 정해지므로, 같은 압축을 넓고 얕은 나무와 좁고 깊은 나무로 나눠 가질 수 있다 — BlazE, CC BY-SA 3.0 (Wikimedia Commons)
성능이 이렇게 매끄럽게 예측된다는 사실 자체가 논문의 주장을 받쳐 준다. 기하를 바꿔도 성능이 요동치는 블랙박스가 아니라, 압축 난이도와 희소성 페널티의 곱으로 설명되는 체계라는 것이다. 저자들은 이 방법이 깊이 1을 넘겨 확장된 최초의 계층적 어텐션 변형이라고 주장한다. 다만 이는 256K까지 측정된 이야기이고, 깊이를 계속 늘리면 최상위 압축률이 함께 커진다는 조건이 붙는다.
논문이 스스로 인정한 구멍
가장 흥미로운 한계는 기술적인 것이 아니라 수학적인 것이다. 층마다 p를 고정하면 유효 임계값은 p의 L승이 되어 깊이가 커질수록 0으로 간다. 그러면 검색 상태가 상수 크기로 수렴하고 성능이 반드시 떨어진다. 반대로 층별 p를 p의 1/L승으로 재조정하면 깊이가 커질수록 p가 1에 가까워져 위층 노드를 전부 선택하게 되고, 다시 이차 비용으로 돌아간다. 준선형을 유지하면서 성능도 지키려면 p를 깊이에 따라, 데이터의 예측 정보 감소 속도에 맞춰 조율해야 한다.
그 속도는 아키텍처가 아니라 데이터의 통계 구조에 달려 있다. 논문은 자연어가 256K까지는 우호적인 멱법칙을 보인다고 확인했지만, 수억 토큰 규모에서도 그 구조가 유지되는지는 검증하지 못했다. 저자들이 밝힌 가장 큰 한계가 바로 이것이다. 100만 토큰 이상을 감당할 만큼 작으면서 성능이 검증된 모델을 구하기 어려워, 초록의 '수억에서 수십억 토큰'은 모델의 외삽이라는 것이다. 여기에 1B 미만 소형 모델에서는 증류 원본의 어텐션 자체가 노이즈여서 변환이 잘 안 됐다는 관찰, NoPE 모델의 장문 외삽이 아직 불확실하다는 단서도 붙는다.
그래도 이 논문이 던지는 질문은 남는다. 우리는 지금 '더 빠른 어텐션'을 만들고 있는 것일까, 아니면 언어 자체가 원래 준선형으로 압축 가능한데 어텐션이 그 구조를 무시하고 전부를 비교하고 있는 것일까. 후자라면 긴 문맥의 병목은 GPU가 아니라 우리가 데이터를 다루는 방식이다. 여러분은 100만 토큰짜리 문서를 넣었을 때, 모델이 '다 읽었다'고 믿으시는 편인가요, 아니면 '잘 찾아냈다'고 믿으시는 편인가요.
참고 자료
Leon Lufkin, Cutter Dawes, Alexander Speicher, Kamesh Krishnamurthy, Tomás Figliolia, Beren Millidge, 「Subquadratic Attention with a Hierarchical Tree-Structured Indexer」, Zyphra Research, arXiv:2610.42112v1 [cs.CL], 2026년 10월 30일 제출, 43쪽.
논문: https://arxiv.org/abs/2610.42112v1
이미지: B+ 트리 구조 — Aexpedito, CC BY-SA 3.0 / 쿼드트리 분할과 트리 표현 — BlazE, CC BY-SA 3.0 (Wikimedia Commons)
댓글1
-
빗방울
2026.11.03 09:24
저도 긴 문서 넣고 '다 읽었겠지' 하고 넘겼다가, 엉뚱한 대목을 자신 있게 인용하는 걸 보고 식은땀을 흘린 적이 있어요. 그래서 이 글에서 제일 와닿은 게 '희소하다고 버릴 수는 없다'는 대목이었습니다. 어떤 질문에 무시당한 부분이 다음 질문에는 결정적일 수 있다니, 캐시를 버리는 방식보다 전부 들고 찾기만 줄이는 쪽이 안전해 보이더군요. 그런데 층마다 p를 고정하면 임계값이 p의 L승으로 줄어든다는 지적은 좀 찜찜합니다. 결국 데이터가 256K 너머에서도 그 멱법칙을 유지해 주느냐에 달린 셈인데, 그건 아직 아무도 못 확인한 거잖아요. 저는 당분간은 '잘 찾아냈다' 쪽을 믿되, 못 찾았을 때를 대비하는 습관을 들이려고요.
모든 이야기1606
가벼운 안부부터 깊은 생각까지, 함께 나눠요.
총 1606개의 이야기