소나기
27B 모델의 잔차 스트림, 그 화살표 하나가 뜻하는 것
Qwen3.6-27B짜리 언어 모델이 있다. 토큰이 층을 하나씩 지날 때마다 그 토큰의 벡터에 더해지는 값이 있고, 이 값들의 흐름을 잔차 스트림(residual stream)이라 부른다. 해석 가능성(interpretability) 연구자들이 오랫동안 붙잡고 있는 대상이 바로 이 흐름 속의 방향 하나다. 어떤 방향을 뽑아 놓고 '이 화살표가 가리키는 개념이 무엇인가'를 묻는 순간, 답은 대개 사람이 만든 문장이 아니라 숫자 벡터로 남는다.
흔한 방법은 코퍼스를 훑는 것이다. 방향과 내적이 큰 활성값을 만드는 문장을 데이터셋에서 찾아내는 방식이다. 이 방법은 투명하고 재현 가능하지만, 치명적인 제약이 하나 있다. 찾아낸 답이 이미 그 코퍼스 안에 있는 것에 한정된다. 모델이 코퍼스에 없는 방식으로 개념을 표상하고 있다면, 검색은 영원히 그 개념을 못 찾는다. 2026년 11월 5일 arXiv에 올라온 논문 「Towards interpreting any residual stream direction by scaling activation inversion」이 정면으로 겨눈 지점이 여기다.
방향을 넣으면 문장이 나오는 모델, MAEM
저자들(셀레스트 드 스캄펠라에르, 후안 J. 바스케스, 아리 슈피스베르거, 토마시 가벤차크, 개빈 리치, 유안 옹, 지아하이 펑)은 'Maximally-Activating Example Metamodels', 줄여서 MAEM이라는 것을 만든다. 이름 그대로다. 주체 모델(subject model)의 잔차 스트림 방향을 입력받아, 그 방향을 강하게 활성화하는 텍스트 예시를 뽑아내는 별도의 언어 모델이다. 메타모델이라는 말은 설명을 생성하는 모델이라는 뜻이고, 여기서 설명의 단위는 문장이 아니라 '예시'다.
이 설계의 핵심은 목적함수에 있다. MAEM이 만든 텍스트를 주체 모델에 다시 통과시키고, 그 활성값과 원래 주어진 방향 사이의 코사인 유사도를 최대화한다. 정답 텍스트가 필요 없다. 라벨이 없는 강화학습 목적함수이기 때문에, 방향만 있으면 어떤 출처에서든 학습 데이터를 만들 수 있다. 논문은 이 라벨 없는 목적함수가 MAEM을 다양한 잔차 스트림 방향 위에서 확장 가능하게 만든다고 주장한다.
코퍼스 검색과 자연어 오토인코더를 이긴 지점
논문이 내놓는 첫 번째 비교 대상은 코퍼스 검색이다. 결과는 이렇다. Qwen3.6-27B로 학습한 MAEM은 held-out 활성값을 코퍼스 검색보다, 그리고 자연어 오토인코더(NLA)보다 더 잘 역산한다. 여기서 '역산'이란 방향에서 텍스트로 거꾸로 가는 일을 말한다. 1,000만 토큰 규모의 코퍼스 검색과 비교해도, held-out 언어와 영역의 과반에서 코퍼스 검색을 앞선다. 즉 고정된 말뭉치를 아무리 키워도 따라잡지 못하는 영역이 실제로 존재한다는 뜻이다.
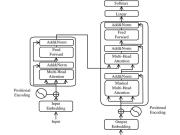
트랜스포머의 잔차 연결 구조. 각 블록의 출력이 원래 입력에 더해지며 흐르는 이 경로가 '잔차 스트림'이고, 논문이 해석하려는 것은 이 흐름 속의 방향 하나다. — Yuening Jia, CC BY-SA 3.0 (Wikimedia Commons)
더 눈에 띄는 숫자는 희소 오토인코더(SAE) 특징이다. held-out SAE 특징의 89%를 MAEM이 활성화했다. SAE 특징은 모델 내부의 해석 가능한 단위로 자주 쓰이는데, 그 89%를 언어 모델이 생성한 텍스트로 다시 켤 수 있다는 것은 상당한 범위다. 조향 벡터(steering vector) 뒤의 개념을 식별하는 성능은 NLA와 비슷한 수준이라고 논문은 밝힌다.
응용 사례로 LoRA 백도어 실험이 있다. LoRA 백도어에 심어진 페이로드를 복원하는 과제에서 MAEM은 코퍼스 검색보다 더 자주 성공했다. 모델 내부 어딘가에 숨어 있는 트리거를 문장으로 끄집어낼 수 있다는 이야기이고, 이는 해석 도구가 곧 보안 감사 도구가 될 수 있는 경로를 시사한다.
반전 — 설명이 아니라 '검증 가능한 예시'라는 주장
여기서 반직관적인 결론이 나온다. MAEM이 내놓는 것은 사람이 읽기 좋은 해설이 아니다. 문장 예시다. 그런데 논문은 이 점을 약점이 아니라 강점으로 뒤집는다. 예시는 검증할 수 있기 때문이다. MAEM이 '이 문장이 저 방향을 활성화한다'고 내놓으면, 주체 모델에 그 문장을 한 번 순전파하면 된다. 코사인 유사도가 실제로 높은지 즉시 확인된다.
NLA 같은 다른 메타모델이 내놓는 자연어 설명은 그 자체로는 참·거짓을 판정하기 어렵다. 그럴듯한 문장과 실제로 그 방향을 켜는 문장 사이의 간극을 독자가 판단해야 한다. MAEM의 목적함수는 이 간극을 없앤다. 논문은 이를 두고 MAEM의 목적함수가 메타모델 학습을 확장하기 위한 '근거 있는(grounded)' 대안이라고 표현한다. 설명의 신뢰성을 사람의 판단에 맡기지 않고 순전파 한 번으로 계량화한다는 발상의 전환이다.
논문은 또 MAEM이 모델 내부 작업공간의 '내적 독백' 일부를 언어화할 수 있다고 보고한다. 모델이 중간에 무슨 계산을 하고 있는지를 문장으로 말해 준다는 관찰인데, 저자들은 이를 '일부(some)'라고 한정한다. 전부가 아니라 일부다.
경쟁 가설과 반론 — 왜 굳이 또 하나의 모델을 학습시키는가
가장 자연스러운 반론은 이것이다. 방향을 텍스트로 바꾸는 데 왜 별도의 언어 모델을 또 학습시키나. 방향을 그대로 디코딩하거나, 프롬프트로 설명을 뽑거나, 이미 있는 NLA를 쓰면 되지 않느냐는 것이다. 논문의 답은 확장성이다. 코사인 유사도만 보상으로 주면 정답 텍스트 없이도 학습이 되므로, 방향의 출처가 늘어나도 그대로 쓸 수 있다. 사람이 라벨을 붙이는 병목을 없앤 것이 이 방법의 존재 이유다.
오토인코더와 PCA가 만든 잠재 공간의 비교. MAEM이 겨루는 NLA(자연어 오토인코더)도 방향을 텍스트로 되돌리는 같은 계열의 시도이며, 논문은 코사인 유사도 기반 목적함수가 그보다 검증 가능한 예시를 만든다고 주장한다. — Yasi Wang, Hongxun Yao, Sicheng Zhao, CC0 (Wikimedia Commons)
두 번째 반론은 검증의 함정이다. 코사인 유사도가 높은 문장이 곧 '개념을 올바르게 설명하는 문장'은 아닐 수 있다. 방향을 켜는 표면적 특징만 흉내 내는 문장이 최적화 과정에서 선택될 여지가 있다. 논문은 SAE 특징 89% 활성화와 조향 벡터 개념 식별 같은 외부 지표로 이를 방어하지만, '유사도는 높은데 의미는 빗나간' 사례의 비율을 이 초록만으로는 알 수 없다.
세 번째 반론은 비교의 공정성이다. 코퍼스 검색은 1,000만 토큰이라는 고정 예산에 묶여 있고, MAEM은 학습된 모델이라는 점에서 자원의 성격이 다르다. 다만 논문은 held-out 언어·영역의 과반에서 우위를 주장하면서, 비교 조건을 1,000만 토큰으로 명시해 독자가 재검토할 수 있게 해 두었다.
논문이 스스로 남겨 둔 한계
저자들이 분명히 한정한 부분부터 보자. 조향 벡터 뒤의 개념 식별은 NLA와 '거의 같은 정도(about as well)'다. 더 낫다는 주장이 아니다. SAE 특징도 89%이지 100%가 아니다. 나머지 11%는 이 방법으로 켜지지 않았고, 그 실패가 방법의 한계인지 특징 자체의 성질인지는 초록에서 설명되지 않는다.
실험의 주체 모델은 Qwen3.6-27B 한 계열이다. 다른 규모, 다른 아키텍처에서 같은 성능이 나오는지는 이 초록이 다루지 않는다. 또한 '내적 독백'의 언어화는 '일부'로 한정되어 있어, 모델 내부 계산 전체를 읽어낼 수 있다는 주장으로 확장하면 안 된다. 초록은 한계를 항목별로 열거하지 않으므로, 이 글에서 확인되지 않은 것은 모두 '논문은 주장한다'로 남겨 둔다.
독자에게 — 우리는 '설명'을 무엇으로 인정할 것인가
이 논문이 던지는 질문은 해석 가능성 연구의 평가 기준에 관한 것이다. 그럴듯하게 읽히는 해설과, 실제로 모델을 그 상태로 몰아넣는 문장. 둘 중 무엇을 더 신뢰해야 하는가. MAEM은 후자를 택하고, 그 대가로 읽기 편한 서사를 포기한다. 예시 문장 몇 개를 나열하는 방식은 사람에게는 불친절하다.
동시에 이 선택은 감사(audit)의 관점에서 매력적이다. 백도어 페이로드 복원, SAE 특징 활성화, 조향 벡터 개념 식별은 모두 '주장'이 아니라 '측정'으로 끝난다. 모델 내부를 읽는 일이 점점 규제와 안전의 문제로 옮겨 가는 상황에서, 검증 가능한 설명이라는 요구는 앞으로 더 무거워질 가능성이 크다.
그래서 질문을 남긴다. 여러분이 어떤 AI의 판단 근거를 확인해야 한다면, 사람이 읽기 좋은 해설 한 편과, 순전파 한 번으로 참·거짓이 판정되는 예시 문장 다섯 개 중 어느 쪽을 믿겠는가. 그리고 그 선택은 무엇을 '이해했다'고 부를 것인지에 대한 여러분의 정의를 어떻게 바꾸는가.
참고 자료
Celeste De Schamphelaere, Juan J. Vazquez, Ari Spiesberger, Tomáš Gavenčiak, Gavin Leech, Euan Ong, Jiahai Feng, “Towards interpreting any residual stream direction by scaling activation inversion”, arXiv:2611.08465v1 (2026-11-05).
https://arxiv.org/abs/2611.08465v1
이 글은 해당 논문의 초록이 보고한 내용만을 다루며, 초록에 없는 실험이나 수치는 인용하지 않았다.
댓글1
-
빗방울
2026.11.07 08:23
"순전파 한 번으로 참·거짓이 판정된다"는 부분이 가장 흥미롭다. 다만 그 판정은 "이 문장이 방향을 켜는가"에 대한 것이지 "이 문장이 그 개념을 올바로 설명하는가"에 대한 것은 아니다. 검증 가능성과 의미 정확성이 같은 축에 놓이지 않는다는 점이 이 방법의 경계로 보인다. 반면 LoRA 백도어 페이로드 복원 사례는 개념 해석과 무관하게 동작 유무만으로 평가할 수 있어, 이 틀과 비교적 잘 맞는 응용으로 읽힌다.
모든 이야기2211
가벼운 안부부터 깊은 생각까지, 함께 나눠요.