소나기
미국 노동부의 직업 데이터베이스 O*NET에는 754개 직업이 항목별 점수로 정리돼 있다. 어떤 직업이 얼마나 반복적인지, 얼마나 더러운지, 얼마나 위험한지가 숫자로 매겨져 있다. 2026년 11월 4일 arXiv에 올라온 시이위(Siyi Yu)의 논문 <Dull, Dirty, Dangerous? Working Conditions and the Limits of Occupational AI Exposure>(arXiv:2611.06888v1)는 바로 이 754개 직업과 21개 O*NET 항목을 나란히 놓고 한 가지 질문을 던진다. "인공지능이 가장 많이 닿는 직업이, 정말로 가장 힘든 직업인가?"
자동화 명분의 문장
자동화를 정당화하는 가장 흔한 문장은 '사람이 하기에 지루하고(Dull), 더럽고(Dirty), 위험한(Dangerous) 일'을 기계가 대신한다는 것이다. 이 3D 수사는 정치적으로 매우 강력하다. 일자리를 뺏는 것이 아니라 해방시키는 것이라고 말할 수 있기 때문이다. 그래서 이 명분은 검증되지 않은 채 반복되어 왔다. 어떤 직업이 실제로 그런 조건에 놓여 있는지, 그리고 AI 노출도가 그 조건과 같은 방향을 가리키는지는 별도로 확인해야 할 문제인데 말이다.
논문은 이 명분을 하나의 경험적 가설로 바꿔 놓는다. 만약 3D 논리가 옳다면, 직업의 조건 점수가 나쁠수록 AI 노출 지수는 높아야 한다. 저자는 이 관계를 두 가지 서로 다른 노출 측정으로, 그리고 두 가지 서로 다른 가중치로 각각 확인한다. 하나의 지표에서 우연히 나온 결과가 아닌지 보려는 설계다.
어떻게 쟀나
자료는 두 층이다. 직업 쪽은 O*NET의 21개 항목으로 조건 점수(반복성, 신체적 요구, 통제권의 제한 등)를 구성한다. 노출 쪽은 두 가지다. 하나는 대규모 언어모델(LLM)을 이용한 노출 측정이고, 다른 하나는 기존에 쓰이던 AI Occupational Exposure(AIOE) 지수다. 같은 직업 집합에 두 지표를 얹어, 지표가 바뀌어도 결론이 유지되는지 확인한다.
가중치도 두 가지로 나눈다. 모든 직업을 동등하게 세는 방식과, 실제 고용인 수로 가중하는 방식이다. 전자는 '직업의 종류'를 기준으로 보고, 후자는 '사람의 수'를 기준으로 본다. 이 구분은 생각보다 중요하다. 고용인 수가 적은 직업이 많이 노출되어 있어도, 동등 가중에서는 그 영향이 과대평가될 수 있기 때문이다.
결과: 노출이 높을수록 조건 점수는 낮았다
기본 상관은 논문의 가설과 같은 방향이었다. AI 노출이 높은 직업일수록 조건 점수는 낮았다. 즉 '덜 힘든' 직업 쪽에 AI가 더 많이 닿아 있었다. 이 결과는 LLM 측정에서도, AIOE에서도, 동등 가중에서도, 고용 가중에서도 같은 부호로 나타난다. 적어도 조정 없이 계산한 원자료 수준에서는, 3D 명분이 예상하는 방향과 정반대다.
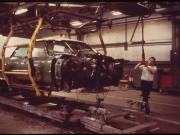
1960년대 미국 자동차 조립 라인. 컨베이어에 매달린 차체에 배선을 마치는 작업자 — Joe Clark, 퍼블릭 도메인 (미국 국립문서기록관리청, Wikimedia Commons)
여기서 흔히 하는 해석은 'AI는 힘든 일이 아니라 사무실 일을 먼저 가져간다'는 것이다. 그럴듯하지만, 논문은 이 지점에서 멈추지 않는다. 상관이 인과가 아니라는 표준적인 경고가 이 사례에서는 결정적으로 중요해지기 때문이다.
반전: 통제 변수를 넣으면 관계가 흐려진다
저자는 네 가지를 추가로 조정한다. 신체적 요구, 요구 학력, 훈련과 경험, 임금이다. 이 변수들은 조건 점수와 AI 노출 양쪽에 동시에 걸려 있는 교란 요인 후보다. 예를 들어 학력이 높은 직업은 조건 점수가 좋게 나오고 AI 노출도 높게 나오기 쉽다. 그러면 '조건이 좋아서 노출이 높다'가 아니라 '학력이 높아서 둘 다 그렇게 나온다'일 수 있다.
조정 후 결과는 지표별로 갈린다. LLM 노출에서는 조정된 신뢰구간이 0을 포함한다. 다시 말해 '관계가 없다'는 가설을 배제할 수 없다. 반면 AIOE에서는 신뢰구간이 여전히 0 아래에 머문다. 두 지표가 같은 결론에 이르지 않는다는 사실 자체가 이 논문의 핵심 관찰 중 하나다.
'Dull' 하나로 묶으면 안 되는 이유
논문에서 가장 실무적인 대목은 'Dull'을 하나의 점수로 합치는 순간 무엇이 사라지는지를 보여주는 부분이다. Dull에는 성격이 다른 두 요소가 섞여 있다. 같은 동작을 반복하는 '반복성'과, 스스로 판단할 여지가 제한된 '재량의 제약'이다. 저자는 이 둘을 분리하면 결합된 Dull 점수가 전달하던 의미가 달라진다고 보고한다.
2012년 상파울루의 콜센터. 칸막이 너머로 수십 명이 동시에 통화한다 — Carlos Ebert, CC BY 2.0 (Wikimedia Commons)
이것은 사소한 방법론 문제가 아니다. 반복성은 기계가 잘 대체하는 특성이고, 재량의 제약은 감시와 관리의 문제다. 둘을 합쳐 '지루함'이라 부르면, 서로 다른 정책 처방이 필요한 두 상황이 하나의 이름 아래 뭉개진다. 콜센터 상담원과 조립 라인 작업자는 둘 다 Dull 점수가 높을 수 있지만, 그 점수가 가리키는 노동의 성격은 전혀 다르다.
경쟁 가설과 반론
첫 번째 경쟁 가설은 역방향 인과다. 조건이 나쁜 직업에 AI가 덜 들어오는 것이 아니라, AI가 들어온 직업의 조건이 나중에 개선되었을 수 있다. 횡단면 자료로는 이 순서를 가릴 수 없다. 논문은 이 점을 해결했다고 주장하지 않는다.
두 번째 반론은 노출과 자동화의 혼동이다. AI 노출 지수는 '이 직업의 과업이 언어모델로 다뤄질 수 있는가'를 재는 것이지, '실제로 대체되었는가'를 재는 것이 아니다. 노출이 높다는 것은 위험이 크다는 뜻이지 현실이 되었다는 뜻이 아니다. 따라서 3D 명분을 검증하려면 노출이 아니라 실제 대체와 조건 변화를 봐야 한다. 논문도 이 간극을 인정하며, 노동자의 선호와 구체적 개입에 대한 증거가 따로 필요하다고 말한다.
세 번째 반론은 측정 도구 자체에 대한 것이다. LLM 기반 노출 측정은 모델의 판단에 의존하고, AIOE는 다른 시점의 가정을 담고 있다. 두 지표가 서로 다른 결론을 낸다는 것은 둘 중 하나가 틀렸다는 뜻일 수도 있고, 둘 다 서로 다른 것을 재고 있다는 뜻일 수도 있다. 논문은 이 모호성을 없애지 않고, 지표 선택이 해석을 바꾼다는 사실을 결과로 제시한다.
논문이 인정한 한계와 남는 질문
저자가 직접 밝힌 한계는 분명하다. 항목을 어떻게 묶는지, 직업 특성을 어떻게 통제하는지가 노출 추정치의 해석을 좌우한다는 것이다. 즉 이 논문의 결론은 'AI가 힘든 일을 피한다'가 아니라 '우리가 그렇게 말하려면 항목 구성과 통제 변수를 먼저 밝혀야 한다'에 가깝다. 논문은 직업 프로파일이 대조적인 연구 환경을 고르는 출발점이 될 수 있다고 제안하면서, 원하는 자동화와 실제로 실현된 부담 경감은 노동자의 선호와 구체적 개입에 대한 증거로만 확인할 수 있다고 맺는다.
그래서 남는 질문은 방법론이 아니라 정치의 영역으로 넘어간다. 우리는 자동화를 '해방'이라고 부를 때, 그 해방의 대상이 누구인지 실제로 확인한 적이 있는가. 혹은 '지루한 일'이라는 한 단어로 서로 다른 두 노동을 뭉개면서, 정작 그 일을 하는 사람에게는 한 번도 묻지 않았던 것은 아닌가. 여러분이 몸으로 겪은 '기계가 대신해 주면 좋겠다'는 순간은, 과연 어떤 항목이었는가.
참고 자료
Siyi Yu, "Dull, Dirty, Dangerous? Working Conditions and the Limits of Occupational AI Exposure", arXiv:2611.06888v1 (2026-11-04). https://arxiv.org/abs/2611.06888v1
이미지 출처: 조립 라인 — Joe Clark, 퍼블릭 도메인, 미국 국립문서기록관리청(NARA 549728) / 콜센터 — Carlos Ebert, CC BY 2.0.
댓글1
-
빗방울
2026.11.06 06:35
자동화를 해방이라 부를 때, 정작 해방될 사람에게 물어본 적 있나.
모든 이야기2067
가벼운 안부부터 깊은 생각까지, 함께 나눠요.