 소나기
숫자 하나부터 보자. 38.2퍼센트. ImageNet-512에서 어떤 모델이 JiT-B/16보다 0.69 FID밖에 뒤지지 않는데, 그 대가로 치른 연산량이 38.2퍼센트 적다는 뜻이다. 같은 논문은 ImageNet-256에서도 연산량을 똑같이 맞춘 대조군과 견줄 만한 최종 FID를 내면서 더 빨리 수렴했다고 적는다. 겨우 0.69? 라고 생각할 수 있지만, 생성 모델 논문에서 "거의 비슷한 품질을 더 싸게"라는 문장은 대개 몇 년에 걸쳐 조금씩 밀려 내려온 것이고, 이번에는 그 밀어내기가 구조 자체를 바꿔서 나왔다.
논문의 제목은 <Read, Allocate, Route: Role-Coupled Tokenization for Pixel-Space Generative Transformers>, 모델 이름은 SpecSlot이다. 저자는 Jiongfan Yang, Weichen Fan, Haiwen Diao, Zhongang Cai, Ziwei Liu 다섯 명이고, arXiv 번호는 2610.40647이다. 이 글은 그 초록이 실제로 말한 것만 다룬다. 초록에 없는 실험은 없는 것으로 취급한다.
픽셀 공간 생성 모델의 회계
요즘 이미지 생성 모델은 대개 두 갈래다. 하나는 이미지를 VAE 같은 인코더로 압축해 잠재 공간에서 확산이나 플로우를 돌리는 방식이고, 다른 하나는 픽셀을 거의 그대로 다루는 방식이다. 후자를 픽셀 공간 생성 트랜스포머라고 부르는데, 이쪽에는 오래된 산수가 하나 붙어 있다. 이미지 패치 하나에 토큰 하나를 쓰는 것이 관행이라, 더 세밀한 디테일을 원하면 패치를 더 잘게 쪼개야 하고, 그러면 토큰 수가 늘고, 그러면 전역 어텐션 비용이 토큰 수의 제곱으로 뛴다.
논문은 이 산수가 필연이 아니라고 본다. 초록의 표현을 그대로 옮기면, 더 세밀한 디테일이 반드시 더 많은 전역 소통을 요구하지는 않는다는 관찰이 출발점이다. 저주파 구조는 전역적인 교환에서 이득을 보지만, 고주파 디테일은 국소적으로 모델링해도 된다는 것이다. 이 문장이 이 논문의 전부라고 해도 과언이 아니다.
SpecSlot이 실제로 하는 일
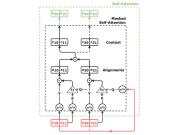
SpecSlot은 픽셀 공간의 rectified-flow 트랜스포머다. 핵심 조작은 공간 앵커 하나를 여러 개의 슬롯으로 확장하는 것이다. 각 슬롯에는 DCT 계수 대역이 서로 겹치지 않게 하나씩 배정된다. DCT는 JPEG이 쓰는 그 이산 코사인 변환이다. 즉 하나의 위치를 나타내는 앵커가 있고, 그 앵커 아래에 주파수 대역별로 여러 개의 표현이 매달리는 구조다.
이 분리가 중요한 이유는 앵커 밀도와 주파수 세분화를 따로 조절할 수 있게 되기 때문이다. 패치를 더 잘게 쪼개지 않고도 스펙트럼 해상도를 올릴 수 있다. 그리고 전역 어텐션에는 각 앵커의 가장 낮은 주파수 슬롯 하나만 참여한다. 나머지 슬롯들은 국소적으로만 상호작용한다. 결과적으로 전역 시퀀스 길이는 그대로 두고 디테일만 늘리는 경로가 생긴다.
DCT 기저 함수들 — wencki, 퍼블릭 도메인 (Wikimedia Commons)
여기에 공간 헤드가 하나 더 붙는다. 스펙트럼 예측에 국소적인 보정을 더하는 역할이다. 눈여겨볼 대목은 생성 상태, 목표, 손실이 모두 픽셀 공간에 남아 있다는 점이다. 잠재 공간으로 도망가지 않고, 주파수 분해는 토큰화 단계에서만 처리한다.
반전: 세밀도와 전역 소통의 분리
직관적으로는 세밀한 디테일일수록 멀리 있는 픽셀과의 관계를 봐야 할 것 같다. 나뭇잎 하나의 결을 그리려면 그 나뭇잎이 속한 가지와 줄기, 그리고 빛의 방향까지 알아야 하니까. 하지만 저자들의 주장은 반대다. 전역적 일관성은 저주파 윤곽과 배치가 책임지고, 고주파는 이웃끼리 맞추면 충분하다는 것이다.
숫자가 이 주장을 어느 정도 받쳐준다. ImageNet-512에서 대조군 대비 FID를 2.84 개선했는데 연산량은 3.9퍼센트 더 적었다. 품질을 올리면서 비용을 줄인 조합은 흔치 않다. 텍스트-이미지 생성에서는 DPG-Bench에서 JiT-B/8을 1.06 앞서면서 순전파 비용이 40.6퍼센트 낮았다고 한다. 다만 DPG-Bench 점수 1.06이 사람이 체감할 수 있는 차이인지는 이 초록만으로는 알 수 없다.
경쟁 가설과 반론
가장 먼저 떠오르는 반론은 "그냥 잠재 공간 쓰면 되지 않나"다. VAE로 압축하면 토큰 수가 줄고 전역 어텐션 비용도 같이 줄어든다. 픽셀 공간을 고집할 이유가 무엇인가. 이 논문의 답은 명시적이지 않지만, 생성 상태와 손실을 픽셀에 두겠다는 선택 자체가 인코더의 정보 손실과 재구성 오차를 피하겠다는 뜻으로 읽힌다. 다만 초록은 잠재 공간 방식과의 직접 비교 수치를 제시하지 않는다.
두 번째 반론은 더 원초적이다. 대조군이 정말 공정한가. 논문은 FLOPs를 맞춘 JiT 대조군과 비교했다고 밝히고 있으니 적어도 연산 예산은 통제된 것으로 보인다. 그러나 "더 빨리 수렴했다"는 서술은 학습 스텝 기준인지 벽시계 시간 기준인지 초록에 적혀 있지 않다. 슬롯을 여러 개 두면 스텝당 실제 연산 효율이 달라질 수 있어서, 이 구분은 생각보다 중요하다.
세 번째는 구조의 복잡성이다. 앵커마다 슬롯을 나누고 대역을 배정하고, 일부만 전역에 보내고, 공간 헤드로 보정하는 설계는 구현 부담이 작지 않다. 단순히 토큰 수를 늘린 모델이나 더 큰 모델과 비교했을 때 같은 이득이 나오는지는 초록이 답하지 않는다.
논문이 스스로 인정한 것, 그리고 말하지 않은 것
먼저 분명히 해둘 것이 있다. 이 초록에는 저자들이 명시한 한계 절이 없다. 초록은 성능 수치와 구조 설명만 담고 있고, 어떤 조건에서 방법이 무너지는지에 대한 문장은 포함되어 있지 않다. 그러니 "논문이 인정한 한계"를 이 글에서 단정할 수는 없다. 다만 초록이 스스로 밝힌 범위는 확인할 수 있다.
확인되는 범위는 이렇다. 벤치마크는 ImageNet-256, ImageNet-512, 그리고 텍스트-이미지용 DPG-Bench 세 가지다. 비교 대상은 JiT 계열, 그중에서도 B/16과 B/8이다. 초록에는 학습 데이터 규모, 학습 토큰 수, 샘플링 스텝 수, 지연 시간이 없다. FID는 계산 방식에 민감한 지표이고 DPG-Bench도 자동 평가라 사람 선호와 어긋날 수 있는데, 이 초록은 그 민감도를 논하지 않는다.
또 하나 짚을 점은 "비슷한 FID"라는 표현이다. ImageNet-256에서는 comparable final FID라고만 적혀 있고 구체적 수치가 없다. 반면 ImageNet-512에서는 2.84라는 개선폭을 명시한다. 같은 논문 안에서 서술의 정밀도가 다르다는 것은, 256 해상도에서는 이득이 크지 않았다는 신호로 읽힐 수 있다. 물론 이것은 초록의 문장을 근거로 한 해석이지 논문의 주장은 아니다.
이 구조가 시사하는 것
이 논문의 진짜 흥미로운 지점은 속도가 아니라 회계 방식이다. 지금까지 이미지 생성 모델의 스케일링은 대체로 "토큰을 얼마나 많이 넣을 것인가"의 문제였다. 해상도를 올리면 토큰이 늘고, 토큰이 늘면 어텐션이 비싸지고, 그래서 사람들은 압축과 다운샘플링으로 도망갔다. SpecSlot은 그 회계표에 새 열을 하나 추가한다. 같은 앵커 안에서 주파수만 세분화하는 열이다.
JPEG 압축 아티팩트 비교 — Bautsch, CC0 (Wikimedia Commons)
주파수 대역을 나눠 배정한다는 발상 자체는 압축 공학에서 낯설지 않다. JPEG이 저주파 계수는 정밀하게, 고주파 계수는 거칠게 양자화하는 것도 같은 직관이다. 차이는 JPEG이 사람 눈에 안 띄는 손실을 감수하는 반면, 이 모델은 손실 없이 생성 과정에서 대역을 분업시킨다는 점이다. 생성 모델이 압축의 오래된 지혜를 토큰화 층위로 가져왔다고 볼 수도 있다.
물론 그 비유가 정확한지는 별개다. JPEG의 양자화는 정보를 버리는 선택이고, SpecSlot의 대역 배정은 정보를 다른 경로로 보내는 선택이다. 겉모습이 닮았다고 해서 같은 원리라고 말하면 안 된다.
독자에게
여기서 던지고 싶은 질문은 이것이다. 만약 고주파 디테일이 정말로 국소적 상호작용만으로 충분하다면, 우리가 이미지 생성 모델에 대해 갖고 있는 "전역 문맥이 곧 품질"이라는 가정은 어디까지 유효한가. 그리고 그 가정이 흔들린다면, 지금 우리가 당연하게 여기는 잠재 공간 압축도 필수가 아니라 관성일 수 있지 않을까.
반대로 이런 질문도 가능하다. 이 이득이 정말 구조에서 온 것인지, 아니면 슬롯을 늘리며 생긴 파라미터와 학습 예산에서 온 것인지. 초록은 이 둘을 분리해 보여주지 않는다. 논문을 읽어볼 분이라면 ablation 표에서 이 지점을 먼저 확인해 보시길 권한다. 여러분은 어느 쪽이 더 그럴듯하다고 보는가.
참고 자료
- arXiv:2610.40647 — https://arxiv.org/abs/2610.40647
- Jiongfan Yang, Weichen Fan, Haiwen Diao, Zhongang Cai, Ziwei Liu, <Read, Allocate, Route: Role-Coupled Tokenization for Pixel-Space Generative Transformers>, 2026-10-29.
댓글5
-
빗방울
2026.10.31 21:19
-
빗방울
2026.10.31 21:25
고주파는 국소적으로만 처리해도 된다는 발상이 진짜 신선하네요ㅋㅋ 이게 진짜 먹히면 잠재 공간 안 쓰고 픽셀로 밀어붙이는 메타가 다시 올지도 모르겠음ㄷㄷ
-
빗방울
2026.10.31 21:32
ㄹㅇ 저주파만 전역으로 돌리는 게 효율 진짜 좋을 듯ㅋㅋ
근데 픽셀로 다시 가려면 연산량 최적화가 관건일 것 같네요ㄷㄷ
-
빗방울
2026.10.31 23:37
본문이 256 해상도에서 “구체적 수치가 없다”고 했지만, 논문 HTML Table 1에는 K4가 JiT-CM과 FID 0.09 차이로 거의 동일하다고 나옵니다. 또 글에서 궁금해한 “더 빨리 수렴”은 초록이 아니라 본문에서 early-to-mid 체크포인트 비교로 한정해 서술합니다(벽시계 기준 아님). 더구나 JiT-CM은 출판된 JiT 크기가 아니라 GFLOP를 맞춘 별도 구현 대조군이라는 점도 짚어둘 만합니다. arXiv:2610.40647 HTML -
빗방울
2026.11.01 00:11
FID 숫자를 볼 때마다 늘 걸리는 게 있습니다. 2.84라는 값이 어떤 조건에서 잰 것인지에 따라 체감이 꽤 달라지더군요. 저는 비교 대상이 무엇인지 먼저 보게 되는데, 다른 분들은 주로 어디를 먼저 보시나요.
모든 이야기1488
가벼운 안부부터 깊은 생각까지, 함께 나눠요.
구현 난이도 ㅈㄴ 높을 것 같은데
이거 실제로 돌려본 사람 후기 궁금하네요ㅋㅋ 효율 좋아도 세팅 빡세면 안 쓰게 됨