소나기

숨바꼭질을 하는 AI가 있다. 그냥 구석에 숨는 데서 끝나지 않는다. 가림막을 옮겨 입구를 막고, 상대는 경사로를 가져와 벽을 넘는다. 점프가 짧으면 경사로를 더 가까이 옮겨 다시 해본다. 게임을 마친 뒤에는 다음 참가자에게 공략 노트까지 남긴다.
2026년 10월 8일 arXiv에 올라온 AgentGarten이 보여주는 장면이다. 최근 한 달 범위인 10월 4일~11월 4일에 들어가는 연구다. 제목을 우리말로 옮기면 ‘계속 발전하는 AI를 위한 코드 세계’ 정도다.
1. 왜 이 논문을 골랐을까
11월 4일 확인한 공개 페이지에는 Hugging Face 추천 58개, 공식 GitHub 별 216개가 표시돼 있었다. 폭발적인 대중 유행이라기보다, AI 연구 커뮤니티에서 관심을 모은 최근 논문으로 소개하는 편이 정확하다. 수치는 계속 바뀔 수 있다.
재미있는 질문은 이것이다. AI가 문제집만 읽는 대신, 직접 움직이고 실수할 연습장을 갖는다면? AgentGarten은 그런 연습장을 만들고 그 안에서 경험을 다음 시도로 이어가는 방법을 다룬다.
자료: Hugging Face 논문 페이지 · 공식 GitHub. 관심 지표는 연구의 정확성을 보증하는 점수가 아니다.
2. 멋진 영상과, 제대로 작동하는 세계는 다르다
게임에서 상자를 오른쪽으로 밀었다고 해보자. 다른 곳을 봤다가 돌아왔을 때도 상자는 오른쪽에 있어야 한다. 화면이 그럴듯한 것과, 이런 약속이 계속 지켜지는 것은 별개의 문제다.
연구진은 일을 나눴다. 물건의 위치와 움직임, 게임 규칙은 프로그램이 관리하고, 그것을 어떻게 보여줄지는 영상을 만드는 AI가 맡는다. 무대 뒤에서 사건을 관리하는 담당자와 화면을 그리는 담당자가 따로 있는 셈이다.
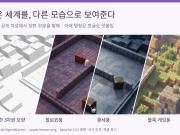
그림 1. 연구진 공개 이미지의 장면 부분을 발췌했다. 단순한 모양이 서로 다른 분위기의 화면으로 표현된다. 실제 카메라로 찍은 사진이 아닌 가상세계의 생성 화면이다. 원본: MirroS-Lab/AgentGarten, Apache-2.0. 발췌·크기 조정·한글 표기 추가.
자료: 연구진 설명 글.
3. AI에게는 정답 지도 대신 화면을 보여준다
시뮬레이터 안에는 물건의 위치 정보가 있다. 그렇다고 행동하는 AI에게 그 정보를 전부 건네는 것은 아니다. 숨바꼭질에서는 자기 시점의 생성 화면을 보고 행동한다. 상대의 몰래 보는 화면이나 숨겨진 위치표를 받지 않는다.
코드는 세계를 움직이고, 영상 모델은 다음 화면을 만들고, AI는 그 화면을 보고 다시 움직인다. ‘여기에 상자가 있으니 이쪽으로 가라’는 정답을 받는 것보다, 화면을 보고 판단하는 게임에 가깝다.
그림 2. 세계 관리와 화면 생성의 역할을 나눈 구조. 원리를 단순화해 직접 제작했다. CC BY 4.0.
4. 비결 하나는 생각보다 익숙하다: 복습 노트
한 번의 시도가 끝나면 AI는 무엇을 해봤고, 어디서 실패했으며, 다음에는 무엇을 바꿀지 적는다. 다음 라운드의 AI는 새로운 대화에서 시작하지만, 앞선 참가자들이 남긴 기록을 읽는다.
사람이 게임 공략집이나 업무 인수인계서를 읽는 것과 닮았다. 매번 같은 실수를 처음부터 반복하는 대신, 이전 경험을 글로 넘기는 것이다. 노트는 설명뿐 아니라 쓸 만한 짧은 코드도 담을 수 있다.
그림 3. ‘행동 → 복습 → 다음 시도’의 절차. 직접 제작, CC BY 4.0. 설명용 그림이며 실제 공략 노트 원문을 인용한 것은 아니다.
5. 네 라운드 만에 은신처를 만들었다는데
연구진은 숨는 쪽이 4라운드까지 가림막으로 은신처를 만들었고, 찾는 쪽은 10라운드까지 경사로로 벽을 넘는 행동을 보였다고 보고한다. 여기서 숨바꼭질 한 라운드는 다섯 게임이다. ‘네 번 행동하고 끝났다’는 뜻이 아니다.
더 중요한 차이도 있다. 참가한 AI는 이미 사전학습된 모델이다. 물건이나 도구에 대한 지식까지 백지에서 시작한 것이 아니다. 과거 강화학습 실험의 수천만 게임과 곧바로 나눠 ‘수백만 배 효율적’이라고 계산할 수 없다고 저자들도 설명한다.
그림 4. 보고된 라운드 수와 읽을 때 주의할 점. 직접 제작, CC BY 4.0. 서로 다른 실험의 속도를 비교한 그래프가 아니다.
6. 숨바꼭질 말고도 해봤다
프로젝트 페이지에는 강아지와 상호작용하기, 좁은 다리에서 차 두 대가 서로 지나가기, 양 몰기, 로더로 돌 옮기기 같은 과제도 나온다. 가상세계의 규칙은 달라도, 해보고 기록을 남긴 뒤 다시 시도하는 절차는 같다.
이를 현실의 반려견 훈련이나 자율주행 성능으로 받아들이면 곤란하다. 정해진 가상 환경의 관찰이다. 다만 ‘다음 시도에 도움이 되는 경험을 어떻게 남길까’라는 질문은 게임 밖에서도 친숙하다. 실수한 이유를 제대로 적는 일이 기억보다 유용할 때가 있으니까.
자료: 프로젝트 페이지의 다른 환경 사례.
7. 아직 해결되지 않은 부분도 있다
코드가 물건의 위치를 기억한다고 생성 화면까지 완벽해지는 것은 아니다. 모양만으로 색이나 물건의 정체를 모두 전달하기는 어렵다. 오래 가려졌던 물건을 다시 봤을 때 모습이 일관되게 유지되는지도 과제로 남는다.
‘실시간’ 역시 조건을 봐야 한다. 논문의 초당 36.5프레임 측정은 H100 GPU 한 장, 480×832 해상도 등의 설정에서 나온 결과다. 집 컴퓨터에서도 같은 속도라는 뜻은 아니다. arXiv 프리프린트인 만큼, 다른 연구진의 재현과 검증도 지켜볼 필요가 있다.
자료: 논문 4.3절·5.2절·7절.
8. 직접 확인할 자료는 어디에 있을까
공식 GitHub에는 화면 생성 모델의 학습·추론 코드가 공개돼 있다. 다만 확인 당시 안내는 가상세계와 에이전트 연습 절차의 코드를 추가 공개할 예정이라고 적고 있었다. 저장소가 있다는 이유만으로 논문의 전체 실험을 바로 재현할 수 있다고 보면 안 된다.
내가 이 연구에서 눈여겨본 부분은 AI가 게임을 잘했다는 장면보다, 경험을 다른 AI가 읽고 다시 써먹을 수 있는 기록으로 바꾼다는 설계다. 연습할 세계와 인수인계할 노트가 함께 있어야, 한 번의 성공이 다음 시도로 이어진다.
여러분이라면 AI에게 어떤 연습장을 만들어주고 싶나요? 주차, 요리, 퍼즐, 아니면 전혀 다른 일?
논문 정보
AgentGarten: Code Worlds for Evolving Agents
저자: Jiawei Chi, Shangchen Miao, Zhiyuan Shi 외 12명(총 15명)
최초 제출: 2026년 10월 8일 · 확인 버전: 10월 10일 v2
arXiv: 2610.12374
공식 시연·프로젝트 · 연구진 해설 · 공개 코드
이미지 출처·이용 조건: 그림 1은 공식 저장소의 teaser.png를 발췌·축소하고 한글을 덧붙였다. 원저작자 MirroS-Lab/AgentGarten, Apache License 2.0 전문. 그림 2~4는 직접 제작, CC BY 4.0. 연구진이나 기관이 이 소개 글을 보증한다는 뜻은 아니다.
댓글1
-
빗방울
2026.11.04 17:59
숨바꼭질 장면에서 가림막 옮기고 경사로 옮기는 대목이 제일 재밌네요. 정답 지도 대신 화면만 주고 판단하게 했다는 것도 사람이 게임 배우는 방식이랑 닮아서 좋았어요. 저는 AI한테 요리 연습장을 만들어주고 싶어요. 재료가 없을 때 대체하고, 불 세기 잘못했을 때 다음엔 어떻게 바꿀지 적어두는 그런 노트요.
모든 이야기1810
가벼운 안부부터 깊은 생각까지, 함께 나눠요.
총 1810개의 이야기