소나기
2026년 11월, 미국의 어느 집. 등에 맥 미니 M4 프로 한 대를 멘 휴머노이드 로봇이 반쯤 열린 문을 옆으로 비집고 지나간다. 사람이 조종하는 사람은 없다. 로봇의 눈은 머리에 달린 120도 화각 카메라 하나뿐이고, 이 집은 학습 데이터에 없던 집이다. 이 논문이 보고한 실험은 그런 식으로 6개의 낯선 실제 주거 공간에서 360번 반복됐고, 성공률은 91%였다.
논문의 제목은 'Perceptive Humanoid Motion from Simulation', 즉 시뮬레이션에서 얻은 지각 기반 휴머노이드 운동이다. 애플 AI/ML 리서치의 시위안 후, 아불리케무 아부두웨일리, 웨 멍, 스펑 리우, 캉탱 르부테, 천 천, 마티아스 뮐러, 블라들렌 콜툰이 쓴 이 글은 겉으로는 로봇 데모 영상처럼 보이지만, 실제로 다루는 것은 데이터 생산 방식에 대한 하나의 주장이다. 그리고 그 주장은 로봇공학보다 데이터 산업에 가까운 곳에 있다.
한 시간의 데이터에는 한 시간의 사람이 필요하다
논문이 첫 문단에서 못 박는 병목은 명확하다. 픽셀과 자연어를 관절 명령으로 연결하려면 짝지어진 감독 데이터가 필요하고, 그런 말뭉치는 충분한 규모로 존재하지 않는다. 대안으로 쓰이는 원격조작과 착용형 캡처 장비는 '한 시간의 데이터를 만들려면 최소 한 시간의 사람 시간이 든다'는 제약을 갖는다. 로봇의 학습 속도가 사람의 촬영 속도에 묶여 있는 셈이다.
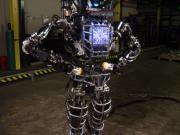
휴머노이드 연구의 상징이 된 보스턴 다이내믹스 아틀라스. HALO가 쓰는 기체는 중국 유니트리의 G1이지만, 2013년 다르파가 공개한 이 사진은 '전신 운동 제어'라는 문제의 난이도를 보여준다 — DARPA, Public domain (Wikimedia Commons)
이 제약은 생각보다 잔인하다. 카메라를 쓰면 되지 않느냐는 반문이 나오지만, 문제는 영상이 아니라 정답이다. 사람이 걸어서 의자에 앉는 영상은 넘쳐나지만, 그 영상에 해당하는 29개 관절 각도와 골반의 3차원 이동이 초당 50번 붙어 있는 데이터는 없다. 이 논문의 출발점은 '사람을 더 많이 찍자'가 아니라 '정답을 사람 없이 계산하자'였다.
천 채의 집을 렌더링해서 300시간을 만든다
파이프라인은 네 단계다. 먼저 인피니젠(Infinigen)으로 거실·사무실·침실 세 종류의 방 1,000개를 절차적으로 생성한다. 다음으로 키모도(Kimodo)라는 운동 확산 모델에 '의자에 앉기' 같은 텍스트와 경유점, 종료 키프레임을 주고 전신 운동을 만든 뒤, 발 미끄러짐·바닥 관통·관절 한계 등 33개의 기하학적 검사를 통과한 후보만 남긴다. 그다음 운동을 방 안의 충돌 없는 위치에 배치하고, 마지막으로 피시아이 렌즈를 흉내 낸 자아중심 카메라로 렌더링한다. 이때 원본 렌더와 함께 모션 블러, 소금-후추 노이즈, 과노출, 저조도, 색온도 편향 등 8가지 시각적 무작위화를 함께 만든다.
결과물은 1,000채의 집에서 얻은 300시간 분량의 에피소드다. 저자들에 따르면 이 합성에는 사람이 개입하지 않으며, H100 250대로 48시간이 걸린다. 즉 데이터의 양이 사람의 근무 시간이 아니라 GPU 시간에 비례하게 된다. 이 논문이 '데이터 병목'이라고 부르는 것의 해법이 데이터를 더 모으는 것이 아니라 데이터를 계산하는 것이라는 주장이 여기서 나온다.
시스템은 세 층으로 나뉜다. 오케스트레이터는 시판 VLM으로, 약 2초마다 사용자의 요청을 '탁자 밑으로 숙이기', '상자 밀기', '의자로 가기' 같은 하위 작업으로 쪼갠다. 운동 생성기는 3Hz로 5초짜리 전신 계획, 즉 36개 값으로 이루어진 150프레임을 만들고 그중 앞의 0.5초 15프레임만 확정해 다음 사이클의 입력으로 되돌린다. 추적기는 50Hz로 그 계획을 따라 29개 관절의 목표값을 내보낸다. 생성기의 인코더는 동결된 Qwen3.5-2B VLM이고, 디코더는 플로 매칭을 쓰는 DiT다. 하드웨어는 유니트리 G1에 머리 장착 OAK-1W 카메라와 등 뒤의 맥 미니 M4 프로(64GB)를 붙인 형태이며, 계획은 맥 미니에서, 실시간 제어는 기체의 젯슨 오린 NX에서 C++ 실시간 프로세스로 돌아간다.
반전: 한 번도 가보지 않은 집에서 91%
이 논문에서 가장 반직관적인 부분은 학습 환경과 평가 환경의 관계다. 훈련은 전부 절차적으로 생성된 가상의 방에서 이루어지고, 실제 주거 공간은 학습 중에 단 한 번도 보지 않는다. 3D 스캔도, 지도 작성도, 궤적 스크립팅도 없다. 그런데 단일 과제 평가에서 시뮬레이션 91%, 실제 환경 91%가 나왔다. 과제별로는 문 옆으로 지나가기 93%, 탁자 밑으로 숙이기 100%, 기어가기 90%, 의자에 앉기 85%였다.
더 눈에 띄는 것은 절제 실험이다. 운동을 배치하는 환경 수를 1개에서 100개로 늘리면 성공률이 43%에서 81%로 뛰고, 1,000개로 늘리면 84%가 된다. 즉 성능을 만든 것은 운동 데이터의 양이 아니라 환경의 다양성이었다. 같은 운동을 한 방에서 백 번 보는 것보다, 백 개의 다른 방에서 한 번씩 보는 것이 훨씬 값어치가 있다는 뜻이다. 실제 가정의 어질러짐을 흉내 내는 대신, 가정의 '변이 폭' 자체를 생성기로 만들어낸 셈이다.
그 91%가 숨기는 것: 사슬은 곱해지지 않는다
단일 과제 91%는 인상적이지만, 여러 과제를 이어 붙이면 숫자가 무너진다. 다중 과제 평균은 시뮬레이션 69%, 실제 70%다. 특히 문 통과 후 물건 찾아가기는 시뮬레이션 71%인데, 단일 과제 성공률을 곱하면 89%가 나와야 한다. 저자들은 이 차이를 정직하게 해석한다. 하위 과제들이 독립이 아니라는 것이다.
테슬라 옵티머스. 상용 휴머노이드의 형태는 이미 정해졌지만, HALO의 논점은 몸이 아니라 '그 몸을 움직이는 데이터를 어디서 얻는가'다 — Steve Jurvetson, CC BY 2.0 (Wikimedia Commons)
원인은 자세다. 실제 환경의 '숙이기→찾아가기→밀기' 실패 5회 중 3회는 숙이는 데 성공했지만 머리가 상자 반대쪽을 향한 채 끝났고, 로봇은 상자를 시야에 넣지 못한 채 다른 물체에 주의를 빼앗겼다. 문을 통과하는 자체는 85%로 성공하지만, 문의 자세가 장면마다 달라 출구 방향이 흔들리고, 그 결과 목표 물체가 시야 밖으로 나가 버린다. 다음 과제가 '목표를 보지 못한 상태'에서 시작하는 것이 공통 원인이라는 분석이다. 저자들이 제안하는 해법은 화려한 것이 아니라, 제자리에서 돌며 찾는 기본 복구 행동이다.
경쟁 가설: 왜 굳이 시뮬레이션인가
반론은 분명하다. 실제 데이터가 최고라면, 원격조작을 자동화하거나 인간 영상에서 3D 자세를 복원하는 편이 낫지 않느냐는 것이다. 실제로 논문이 인용하는 HDMI, TWIST 같은 계열은 사람 영상과 착용 장비에서 출발한다. 이 논문의 절제 실험은 그 반론에 대한 간접 응답이다. 깊이 입력을 빼면 성공률이 84%에서 74%로 떨어지고, 회귀 디코더로 바꾸면 19%까지 추락한다. 즉 성능의 상당 부분이 '지각 입력의 질'과 '생성 모델의 표현력'에서 나오지, 단순히 데이터를 많이 넣어서 나오는 것이 아니다.
또 하나의 반론은 시뮬레이션-실제 격차다. 사실 이 논문도 그 격차를 완전히 없앴다고 말하지 않는다. 다만 격차를 줄이는 방법으로 물리 파라미터 무작위화보다 '시각적 무작위화와 환경 다양성'을 택했다. 카메라 렌즈를 하드웨어와 일치시키고, 조명과 색조를 흔들고, 방의 배치를 1,000가지로 늘리는 방식이다. 이 접근이 통했다는 증거가 바로 6개 미지 환경의 360회 시험이라는 숫자다. 다만 그것은 '가정용'이라는 특정 분포 안에서의 성공이다.
저자들이 스스로 인정한 네 가지 구멍
논문의 한계 절은 이 글에서 가장 솔직한 부분이다. 첫째, 데이터 수집에서는 사람을 없앴지만 과제 설계에서는 없애지 못했다. 새 과제를 추가하려면 여전히 사람이 프롬프트를 쓰고 운동 시퀀스의 키프레임을 직접 저작해야 한다. 즉 로봇이 할 수 있는 일의 목록은 사람이 지정할 수 있는 속도로만 늘어난다. 둘째, 감각이 사실상 시각에 의존한다. 물체가 카메라 시야를 벗어나거나 가려지면 정책은 그것이 여전히 존재한다는 신호를 갖지 못하고, 접촉이 중요한 과제의 성능이 떨어진다.
셋째, 운동 생성기와 추적기 사이의 인터페이스가 좁다. 추적기는 운동학적 계획을 따르지만 그 계획이 무엇을 위한 것인지 모른다. 넷째, 오케스트레이션 계층이 비교적 단순하다. 과제 목록이 커지면 더 에이전트적인 시스템이 필요할 것이라고 저자들은 예상한다. 이 네 가지를 읽고 나면, 이 논문이 증명한 것은 '범용 휴머노이드의 완성'이 아니라 '데이터 생산 병목의 우회로가 실제로 존재한다'는 정도다.
독자에게
이 논문이 흥미로운 이유는 로봇이 문을 통과해서가 아니다. 사람의 시간을 GPU 시간으로 바꿀 수 있다는 주장이, 적어도 좁은 영역에서는 숫자로 확인됐다는 점이다. 그렇다면 다음 질문은 자연스럽다. 세상의 모든 '몸으로 배우는 일'이 이렇게 대체될 수 있는가. 아니면 손끝의 감각처럼 카메라가 끝내 담지 못하는 것이 남는가.
한 가지 더. 이 시스템은 300시간의 합성 데이터를 48시간 만에 찍어냈지만, 그 데이터를 만들기 위한 과제 설계는 여전히 사람의 몫이었다. 자동화가 자동화되지 않은 부분을 어디로 밀어내는지가, 아마 다음 5년의 실제 쟁점일 것이다. 여러분은 휴머노이드가 '집에서' 쓸 만해지려면 무엇이 먼저 풀려야 한다고 보는가 — 손끝의 촉각인가, 아니면 일을 시키는 쪽의 언어인가.
참고 자료
Siyuan Hu, Abulikemu Abuduweili, Yue Meng, Shipeng Liu, Quentin Leboutet, Chen Chen, Matthias Müller, Vladlen Koltun, 'Perceptive Humanoid Motion from Simulation', arXiv:2611.06908v1 (cs.RO), 2026년 11월 4일 제출. https://arxiv.org/abs/2611.06908v1
프로젝트 페이지(코드·영상): https://apple-aiml-research.github.io/ml-halo/ — 본문의 수치(300시간, 1,000채, 91%, 360회, 69~70%, 절제 실험 값)는 모두 이 논문의 본문과 표에서 가져왔다.
댓글1
-
빗방울
2026.11.05 22:31
절제 실험에서 환경 수를 1개에서 100개로 늘릴 때 성공률이 43%에서 81%로 뛰는 대목이 제일 눈에 들어와요. 데이터 양보다 다양성이 중요하다는 걸 숫자로 보여주니까 설득력이 있네요. 다만 다중 과제로 이어 붙이면 91%가 70%로 떨어지는 것도 같이 놓지 말아야 할 것 같아요. 그래서 궁금한 게, "제자리에서 돌며 찾기" 같은 복구 행동도 지금은 사람이 설계한 거잖아요. 이걸 시뮬레이션 안에서 실패로부터 스스로 배우게 두면 어디까지 갈까요. 논문은 arXiv 2611.06908에서 볼 수 있어요.
모든 이야기2004
가벼운 안부부터 깊은 생각까지, 함께 나눠요.
총 2004개의 이야기