소나기
코딩 에이전트가 31번째 스텝에 도착했다. 앞의 30스텝 동안 파일을 열고, 테스트를 돌리고, 패치를 고쳐 왔다. 이 시점에 모델이 내리는 판단은 1번째 스텝의 판단과 같은 무게를 가져야 한다. 그런데 arXiv에 2026년 11월 3일 올라온 논문 하나는, 바로 이 지점에서 조용한 것이 하나 끼어든다고 주장한다. 추측 디코딩(speculative decoding)의 검증 창 안에서 수치 잡음이 자라나고, 그 잡음이 30스텝쯤 지나면 출력 분포를 바꿔 놓는다는 것이다.
추측 디코딩은 원래 '속도' 장치였다
추측 디코딩의 통념은 단순하다. 작고 빠른 초안 모델(draft model)이 토큰 몇 개를 먼저 찍고, 큰 목표 모델(target model)이 그것을 한 번에 검증한다. 맞으면 여러 토큰을 한 번에 얻고, 틀리면 그 지점부터 다시 뽑는다. 이 과정에서 목표 모델의 출력 분포는 바뀌지 않는다고 여겨 왔다. 같은 분포에서 더 빨리 뽑는 방법일 뿐이라는 것이다.
그래서 초안 모델을 개선하는 연구는 거의 전부 수용률(acceptance rate)을 올리는 쪽으로 향했다. 더 잘 맞히는 초안 모델이 더 많은 토큰을 한꺼번에 통과시키고, 그러면 디코딩이 빨라진다. Hongyin Luo 등 여덟 명의 저자는 이 전제가 긴 호흡의 에이전트 추론에서는 성립하지 않는다고 본다. 속도의 문제로만 다뤄 온 장치가, 실은 추론의 정확도에 손을 대고 있었다는 주장이다.
'검증 창' 안에서 자라는 수치 잡음
논문이 지목하는 지점은 검증 창, 즉 초안 모델이 여러 토큰을 밀어 넣고 목표 모델이 한 번에 확인하는 구간이다. 저자들은 프런티어 오픈웨이트 모델들을 복잡한 에이전트 과제에 올리고, 추측 디코딩 방식을 바꿔 가며 측정했다. 그 결과 이 구간 안에서 수치 잡음이 누적되고, 그렇게 수용된 사고 과정 토큰들이 30스텝 뒤의 출력 분포를 실제로 흔든다고 보고한다.
중요한 것은 흔들리는 방향이 일정하지 않다는 점이다. 저자들의 표현대로 추론 정확도가 '무작위한 방향으로' 눈에 띄게 영향을 받는다. 어떤 실행에서는 조금 나아지고, 어떤 실행에서는 나빠진다. 성능이란 게 원래 그런 것이 아니냐고 반문할 수 있지만, 문제는 이 흔들림이 목표 모델의 능력과 무관한 곳에서 생긴다는 데 있다. 모델을 바꾸지 않았는데도 결과가 달라진다면, 그 차이는 모델의 실력이 아니라 디코딩 경로의 잡음이다.
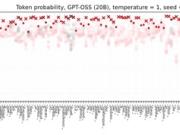
GPT-OSS 20B가 사고 과정을 생성할 때 각 토큰 위치에서의 상위 토큰 확률 분포(로그 스케일). 같은 프롬프트에서도 후보 확률이 위치마다 크게 요동친다 — Hjhornbeck, CC BY-SA 4.0 (Wikimedia Commons)
반전: 초안 모델을 '틀리도록' 학습시킨다
여기서 논문은 방향을 뒤집는다. 보통은 초안 모델이 목표 모델과 비슷해지도록 학습시킨다. 이 논문은 반대로, 결정적인 추론 지점에서 초안 모델이 거절당하도록 학습시킨다. 저자들은 에이전트의 추적 기록 안에서 그런 결정점들을 찾아내고, 초안 모델이 적대적 선호(adversarial preference)를 갖도록 훈련한다.
그래서 추론 시점에 초안 모델과 목표 모델은 정확히 그 지점에서 갈라진다. 검증이 다시 시작되고, 결정적인 사고 토큰은 목표 모델이 직접 뽑는다. 저자들의 표현을 빌리면, 그 토큰이 목표 모델의 '가장 잡음이 적은 조건'에서 인코딩된다. 초안 모델을 똑똑하게 만드는 대신, 가장 중요한 순간에만 입을 다물게 만드는 셈이다.
왜 '거절'이 정밀도를 올리는가
핵심은 목표 모델이 검증하는 전체 토큰 분포는 바꿀 수 없다는 점이다. 저자들도 이 점을 인정한다. 대신 바꿀 수 있는 것은 어느 토큰이 어떤 조건에서 표본화되느냐다. 초안 모델이 통과시킨 토큰은 검증 창이라는 조건 아래 목표 모델의 분포에서 나오고, 초안 모델이 거절당한 뒤 다시 뽑힌 토큰은 조건이 초기화된 상태에서 나온다. 논문은 이 차이가 결정적 추론의 '색인 가능성'과 긴 호흡에서의 지속성(durability)을 높인다고 주장한다.
비유하자면 이렇다. 빠른 조수가 원고를 대신 써 주면 작업은 빨라지지만, 조수가 넘겨준 문장은 이미 조수의 손때가 묻어 있다. 이 논문의 방법은 조수에게 '여기서는 절대 대신 쓰지 마라'고 가르치는 것이다. 조수가 멈춰야 할 자리를 정확히 알면, 원고의 핵심 문장은 원저자의 손에서 가장 깨끗한 상태로 다시 쓰인다. 그리고 저자들은 이 효과가 복잡한 에이전트 코딩 벤치마크에서 엔드투엔드 성공률을 끌어올린다고 보고한다.
경쟁 가설과 반론
가장 먼저 나올 반론은 '그건 그냥 다른 샘플링 시드 효과 아니냐'이다. 거절이 일어나면 난수 흐름이 달라지고, 긴 호흡 과제는 원래 실행마다 편차가 크다. 논문은 목표 모델과 그 출력 분포를 바꾸지 않았다고 강조하지만, 독자 입장에서는 분산이 큰 벤치마크에서 평균 성공률 차이가 통계적으로 얼마나 안정적인지가 먼저 궁금해진다. 초록에는 반복 횟수나 신뢰구간이 제시되지 않는다.
두 번째 반론은 속도다. 초안 모델을 일부러 거절당하게 만들면 수용률은 필연적으로 떨어진다. 즉 이 방법은 추측 디코딩의 원래 목적인 속도를 일부 포기하고 정확도를 사는 거래일 수 있다. 논문은 초안과 목표가 갈라지는 지점을 결정적 추론에 한정한다고 하지만, 실제 배포 환경에서 그 '결정적 지점'을 얼마나 정확히 짚어내는지, 그리고 짚어내지 못했을 때의 비용은 얼마인지는 초록만으로 판단할 수 없다.
세 번째는 학습 대상의 범위다. 저자들은 호스팅되는 파라미터의 0.06%에서 0.28%만 훈련했다고 밝힌다. 이는 매우 가벼운 개입이라는 점에서 매력적이지만, 동시에 그 0.06~0.28%가 어떤 에이전트 추적 기록에서 뽑혔는지에 결과가 크게 의존할 수 있다는 뜻이기도 하다. 훈련에 쓴 과제 분포와 다른 종류의 장기 과제에서도 같은 효과가 나오는지는 이 논문이 답하지 않은 질문이다.
논문이 스스로 인정한 한계
저자들이 명시한 범위는 분명하다. 목표 모델 자체와 그 출력 분포는 바꾸지 않는다. 방법의 검증도 복잡한 에이전트 코딩 벤치마크에 집중되어 있다. 즉 '에이전트가 코딩 과제를 끝까지 해내는 비율'이라는 한 가지 지표에서의 개선이며, 그 밖의 추론 과제나 다른 모델 계열로 일반화된다는 주장은 초록에 없다.
또 하나 흥미로운 지점은 논문이 잡음의 존재를 '발견'으로 제시한다는 것이다. 추측 디코딩이 출력 분포를 바꾸지 않는다는 통념이 사실은 근사였다는 주장인데, 그렇다면 이는 특정 구현의 문제인지, 아니면 검증 창이라는 구조 자체의 성질인지가 갈린다. 전자라면 구현을 고치면 되고, 후자라면 추측 디코딩을 쓰는 모든 긴 호흡 에이전트가 같은 조건에 놓인다. 논문은 이 구분을 결론으로 밀어붙이기보다, 잡음을 통제 가능한 자원으로 다루는 쪽을 택한다.
독자에게 던지는 질문
이 논문이 흥미로운 이유는 성능 숫자보다 관점의 전환에 있다. 추측 디코딩을 '가속기'에서 '맥락 정밀도의 능동적 배분기'로 다시 부르자는 제안은, 우리가 모델의 사고 과정을 어디까지 신뢰할 수 있는지에 대한 질문으로 이어진다. 같은 모델, 같은 프롬프트, 같은 과제인데 디코딩 경로만 달라져도 30스텝 뒤의 결론이 흔들린다면, 우리가 '모델의 실력'이라고 부르는 것에는 얼마나 많은 부분이 측정 경로의 잡음일까.
그리고 실무적인 질문이 하나 남는다. 여러분이 에이전트를 운영한다면, 속도를 위해 초안 모델의 수용률을 높이는 쪽을 택하겠는가, 아니면 결정적 순간에 초안 모델을 침묵시키는 쪽을 택하겠는가. 정답이 갈리는 지점은 아마 '그 결정적 순간을 얼마나 믿을 수 있게 찾아낼 수 있는가'일 것이다.
참고 자료
Hongyin Luo, Wei Fang, Lijie Yang, Owen Stepan, Daniel Suit, Jeff Krapf, Dana Wensberg, Jack O'Brien, 'Adversarial Speculative Reasoning Improves Long Horizon Agents', arXiv:2611.05345v1 (2026-11-03). https://arxiv.org/abs/2611.05345v1
이미지: 'Top token probabilities, chain of thought response only, for GPT-OSS (20b)' — Hjhornbeck, CC BY-SA 4.0, Wikimedia Commons.
댓글1
-
빗방울
2026.11.05 09:26
초안 모델을 더 잘 맞히게 만드는 대신, 결정적 순간에 일부러 거절하게 학습시킨다는 발상이 흥미롭네요. 보통은 수용률을 올리는 쪽으로만 연구가 가는데, 정확도를 사려고 속도를 포기하는 거래라는 반론도 설득력 있어요. 저는 0.06%만 훈련했다는 부분이 특히 눈에 밟히네요. 그 지점을 얼마나 일반적으로 찾아낼 수 있는지가 관건일 것 같아요.
모든 이야기1917
가벼운 안부부터 깊은 생각까지, 함께 나눠요.