소나기
숫자 하나로 시작하자. 시시각각 변하는 장면에서 R² ≈ 0.8~0.9, 시간 평균에서는 R² ≈ 0.95. 기후 모델의 격자 안쪽에서 벌어지는 소용돌이의 운동에너지를 컨볼루션 신경망이 오프라인으로 예측했을 때 나온 점수다. 영국 기상청 계열 지구시스템 모델(UK Earth System Model)을 위한, 기계학습 기반의 스케일 인지 GEOMETRIC 에디 폐쇄(eddy closure)를 향한 첫 단계라고 저자들은 밝힌다.
논문은 토머스 와일더, 란지니 스와미나단, 데이비드 스토키, 틸 쿨브로트가 쓴 Evaluating the prediction of subgrid eddy kinetic energy from a machine learning model, arXiv:2611.06539v1(2026년 11월 4일)이다. 주제는 화려하지 않다. 지구 전체를 계산하는 모델의 격자 하나가 수십~수백 km인데, 그 안에서 실제로는 더 작은 규모의 소용돌이가 열과 운동량을 실어 나른다. 그 실어 나름을 격자 안에 감춰두면 모델은 반드시 어딘가에서 틀린다.
격자 안쪽은 계산되지 않는다
전지구 기후 모델의 해상도는 여전히 중규모(mesoscale) 과정을 스스로 풀어내기에 너무 거칠다. 그래서 아격자 폐쇄(subgrid closure)가 필요하다. 격자로 표현되지 않는 에디가 격자 규모의 흐름에 되돌려주는 피드백을 근사하는 것이다. 지금까지는 물리적 가정에 기댄 매개변수화가 이 자리를 채웠다.
논문이 지적하는 변화는 데이터 쪽에 있다. 고해상도 데이터셋이 흔해지면서, 새 폐쇄를 기계학습으로 개발하려는 시도가 빠르게 늘었다. 문제는 이 방식이 "그럴듯한 그림"을 잘 만든다는 데 있지 않다. 학습한 지역 밖에서도 같은 규칙이 통하는지가 검증되지 않으면, 그것은 물리 매개변수화가 아니라 훈련 데이터의 암기다.
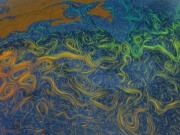
멕시코만류를 따라 흐르는 표층 해류와 수온. 격자 하나가 수십~수백 km인 전지구 모델은 이 그림에 보이는 소용돌이의 세부를 직접 계산하지 못하고, 그 통계적 효과를 격자 안에 근사해 넣어야 한다 — 그레그 시라(수석 애니메이터), NASA Scientific Visualization Studio, 퍼블릭 도메인 (Wikimedia Commons)
방법: 지구를 잘라서, 하나씩 빼보기
저자들이 택한 것은 오프라인 학습이다. 모델을 돌리면서 실시간으로 신경망을 부르는 대신, 고해상도 데이터에서 얻은 참값과 격자 규모 변수들을 짝지어 놓고 컨볼루션 신경망이 아격자 에디 운동에너지(KEe)를 맞히도록 훈련한다. 목표는 앞서 말한 GEOMETRIC 계열 폐쇄의 초기 토대다.
핵심 설계는 두 종류의 절제(ablation) 실험이다. 하나는 지역 절제로, 어떤 지역 데이터로 배운 모델이 다른 지역에서도 통하는지 본다. 다른 하나는 특징 절제로, 입력 변수 묶음에서 일부를 빼면 성능이 어떻게 달라지는지 본다. 이 두 실험이 논문 제목의 "평가"에 해당한다. 성능 자랑이 아니라, 어디까지 믿을 수 있는지를 재는 작업이다.
반전: 전지구 모델 하나가 지역 모델들을 이겼다
직관적으로는 지역별 폐쇄가 더 정확할 것 같다. 지역마다 해양의 성질이 다르니, 지역에 맞춘 매개변수화가 유리하다는 발상이다. 논문이 던진 질문이 정확히 이것이다. 전지구적 매개변수화가 필요한가, 아니면 지역 폐쇄로 충분한가.
결과는 지역 모델의 손을 들어주지 않는다. 모든 지역 데이터로 학습한 최고 성능 모델이 시간 평균 R² 0.95, 이상(anomaly) R² 0.8~0.9를 기록했다. 그리고 논문은 일반화의 조건을 분포로 설명한다. 학습 데이터가 대상 지역과 비슷한 특징 분포 및 목표 분포를 공유하면, 모델은 보지 못한 지역으로도 일반화된다. 요약하면 "지역을 나누느냐"가 아니라 "분포가 겹치느냐"가 관건이라는 주장이다.
실패하는 모델은 왜 실패하는가
일반화에 실패한 모델에는 두 가지 이유가 붙는다. 첫째는 분포 이동(distributional shift)이다. 훈련 때 본 입력 분포와 대상 지역의 분포가 어긋나면 예측이 무너진다. 둘째는 더 기술적인데, 참 KEe 장을 만들 때 쓴 필터링 스케일이 모델마다 다르다는 점이다. 같은 이름의 목표값이라도 걸러내는 규모가 다르면, 모델은 서로 다른 문제를 풀고 있게 된다.
멕시코만류와 주변 해역의 표층 수온. 고해상도 관측·재분석 자료가 참값의 기준이 되지만, 그 참값을 어떤 필터 규모로 정의하느냐에 따라 신경망이 배우는 문제 자체가 달라진다 — NOAA, 퍼블릭 도메인 (Wikimedia Commons)
이 두 번째 지적은 방법론 비판으로 읽힌다. 기계학습 폐쇄 연구들 사이에서 "우리 모델이 더 잘 맞힌다"는 비교가 성립하려면, 애초에 같은 목표를 정의했는지부터 확인해야 한다는 뜻이기 때문이다. 논문은 이 지점을 자기 실험의 통제 조건으로 삼는다.
특징을 빼면 좋아진다? 지역에 따라 갈린다
특징 절제에서는 흥미로운 결과가 나온다. 일반화가 잘 되는 모델들 사이에서는 입력 특징을 일부 빼는 것이 오히려 성능을 개선했다. 변수를 더 넣으면 정보가 늘어날 것 같지만, 실제로는 잡음과 과적합의 통로가 함께 열린다. 이는 아격자 폐쇄에서 흔히 관찰되는 현상과 방향이 같다.
그러나 이 개선은 보편적이지 않다. 어떤 특징 공간은 특정 지역에서는 성능을 끌어올리고, 다른 지역에서는 떨어뜨린다. 논문은 이 비대칭을 숨기지 않는다. "전지구 모델 하나로 충분하다"는 결론과 "지역별 튜닝이 필요하다"는 반론이 동시에 성립하는 지점이 여기다. 평균 성능이 좋다는 사실이 모든 지역에서 좋다는 사실을 함의하지 않는다.
스펙트럼은 작은 규모에서 발산한다
논문이 스스로 인정하는 가장 뼈아픈 한계는 파워 스펙트럼이다. KEe의 파워 스펙트럼 밀도는 일반적으로 작은 규모에서 발산하는 경향을 보인다. 격자 규모로 갈수록 에너지가 실제보다 과도하게 실리는 것이다. 평균과 이상값의 R²가 0.95, 0.9여도, 스펙트럼이 작은 규모에서 벌어지면 그 모델을 장기 적분에 넣었을 때 격자 규모에 에너지가 쌓일 위험이 남는다.
다만 저자들은 어떤 특징 공간을 쓰면 이 발산을 줄일 수 있다고 보고한다. 즉 스펙트럼 거동이 입력 변수 선택에 민감하다는 것이고, 이는 앞의 특징 절제 결과와 같은 방향의 관찰이다. 여기서 논문이 명시하지 않은 것은 남은 발산이 장기 적분에서 실제로 얼마나 해로운가 하는 문제다. 오프라인 평가만으로는 답할 수 없는 영역이고, 논문도 그 선을 넘지 않는다.
이 논문이 남긴 질문
정리하면 이렇다. 컨볼루션 신경망은 아격자 에디 운동에너지를 시간 평균 R² 0.95 수준으로 예측한다. 지역을 나누는 것보다 학습·대상 분포의 유사성이 일반화를 결정하며, 참값의 필터링 스케일이 다르면 비교 자체가 어긋난다. 그리고 스펙트럼 발산은 남은 숙제다. 이 네 문장이 논문의 골격이다.
독자에게 남는 질문은 이것이다. 우리는 기후 모델의 오차를 줄이려는 것인가, 아니면 신경망이 훈련 데이터를 잘 재현하는지 확인하려는 것인가. 오프라인 R²는 후자에 가깝고, 전자는 온라인 적분에서만 판정된다. 논문은 그 다리까지 놓지 않았고, 놓았다고 주장하지도 않는다.
참고 자료
· Thomas Wilder, Ranjini Swaminathan, David Storkey, Till Kuhlbrodt, Evaluating the prediction of subgrid eddy kinetic energy from a machine learning model, arXiv:2611.06539v1 (2026-11-04) — https://arxiv.org/abs/2611.06539v1
· 이미지 1: NASA Scientific Visualization Studio, Greg Shirah (lead animator), 퍼블릭 도메인, Wikimedia Commons
· 이미지 2: NOAA, 퍼블릭 도메인, Wikimedia Commons
댓글1
-
빗방울
2026.11.06 00:25
"분포가 겹치느냐가 관건"이라는 결론은 결국 고해상도 참값이 얼마나 넓게 깔려 있느냐에 달린 문제 아닐까요? 그렇다면 학습 지역의 분포를 모르는 새 해역(예컨대 남극해)은 그냥 위험 지역으로 남는 건가요? 그리고 스펙트럼이 작은 규모에서 발산하는 걸 특징 선택으로 줄일 수 있다면, 그건 물리를 배운 게 아니라 필터에 맞춰진 건 아닌지도 궁금하네요.
모든 이야기2018
가벼운 안부부터 깊은 생각까지, 함께 나눠요.
총 2018개의 이야기