소나기
2026년 11월의 어느 예보실. 예보관이 30개 멤버로 돌린 앙상블 예보를 놓고 앙상블 평균과 관측값의 상관계수 r을 계산해 0.62를 얻는다. 지난달 같은 모델을 50개 멤버로 돌렸을 때는 0.68이었다. 모델도, 관측도, 예보 기간도 그대로인데 멤버 수만 바꿨더니 성적표가 달라졌다. 어느 쪽이 진짜 실력인가. 크리스토퍼 데이비드 로버츠가 2026년 11월 5일 arXiv에 올린 논문 「Estimating ensemble-mean anomaly correlations and the ratio of predictable components using an unbiased estimate of the predictable signal variance」(2611.07878)는 정확히 이 불편한 장면에서 출발한다. 위 숫자들은 설명을 위한 가상의 예시이고, 논문이 실제로 다루는 것은 그 뒤에 있는 산수다.
멤버 평균에 섞여 들어온 잡음
앙상블 평균과 관측의 상관 r은 날씨·기후 예측 공동체에서 가장 흔히 쓰는 예보 품질 지표다. 문제는 이 값이 표본에서 계산된다는 점이다. 유한한 멤버 수로 만든 앙상블 평균에는 예측 가능한 신호뿐 아니라, 멤버마다 제각각인 예측 불가능한 잡음도 함께 평균되어 들어간다. 잡음은 관측된 진실과 상관이 없으므로, 평균 과정에서 신호를 희석한다.
결과는 단순하다. 멤버 수가 적을수록 잡음이 덜 상쇄되어 r이 0 쪽으로 끌려간다. 즉 보정하지 않은 r은 예보 시스템의 성질이 아니라 앙상블 크기의 함수이기도 하다. 논문은 이 편향을 다루는 기존의 앙상블 크기 조정법들을 정리하는 데서 한 걸음 더 나아간다.
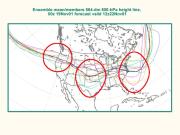
같은 예보를 여러 멤버로 그린 500hPa 고도선(스파게티 플롯). 선들이 갈라지는 폭이 곧 표본 잡음의 크기다 — Environmental Modeling Center(NOAA/NWS), Public domain (Wikimedia Commons)
r∞: 신호 분산을 편향 없이 세는 발상
논문이 성질을 규명하는 추정량은 r∞다. 이름의 무한대는 멤버 수를 무한히 늘렸을 때의 극한, 즉 앙상블 크기에 의존하지 않는 값을 겨냥한다는 뜻이다. 핵심은 분모와 분자에 들어가는 예측 가능한 신호의 분산을 표본에서 편향 없이 추정하는 것이다. 앙상블 평균의 분산에서 표본 잡음이 만들어내는 기대 분산을 걷어내면, 멤버 수와 무관한 신호 분산 추정치가 남는다.
이 추정치를 상관 계산에 넣으면 r은 멤버 수를 바꿔도 거의 움직이지 않는다. 논문은 이 추정량의 거동을 이론적으로 특성화하고, 어떤 조건에서 쓸 수 있고 어디서 무너지는지를 정리한다. 방법 자체는 새로운 이론이라기보다, 현장에서 재현 가능한 산수에 가깝다.
요구 조건은 생각보다 훨씬 느슨하다
직관적으로는 "예보가 관측과 통계적으로 같은 분포를 가져야 한다"는 신뢰성(reliability) 가정이 필요할 것 같다. 실제로 많은 앙상블 기법이 그 가정 위에 서 있고, 예보가 과소·과대 산포를 보이면 지표가 조용히 틀어진다. 그런데 r∞가 요구하는 것은 다르다.
논문에 따르면 조건은 두 가지다. 첫째, 한 사례 안의 예보 멤버들이 서로 교환 가능해야 한다. 즉 멤버들을 그 사례에 특정한 예측 분포로부터의 독립적인 추출로 해석할 수 있어야 한다. 둘째, 각 멤버의 예측 불가능한 성분이 관측된 진실과 상관이 없어야 한다. 예보와 관측이 서로 통계적으로 교환 가능할 필요는 없다. 그래서 r∞는 신뢰성 있는 예보에도, 그렇지 않은 예보에도 쓸 수 있다.
허리케인 리타 사례의 앙상블 경로와 강도 예측. 멤버들이 하나의 예측 분포에서 나온 교환 가능한 추출이라는 가정이 r∞의 출발점이다 — Prof. Robert Fovell(UCLA)·Dr. Hui Su(JPL), Public domain (Wikimedia Commons)
-1과 1 사이를 벗어나는 값이 답이 될 때
여기에 논문의 가장 반직관적인 대목이 있다. r∞는 어떤 상황에서 정의되지 않을 수 있다. 추정된 신호 분산이 음수로 나오는 경우다. 또는 신호가 표본 불확실성에 비해 작을 때 r∞가 허용 범위인 -1 이상 1 이하를 벗어날 수도 있다.
보통 상관계수가 1.2나 -1.3으로 나오면 계산 버그를 의심한다. 그러나 논문은 이 부적절한 값들을 실패가 아니라 증거로 읽는다. 관측된 사례 수와 앙상블 크기로는 진짜 예측 가능한 신호를 분해해낼 수 없다는 뜻이라는 것이다. 숫자가 범위를 벗어나는 순간이 "이 데이터로는 답할 수 없다"는 가장 정직한 보고가 되는 셈이다.
RPC: 분산 기반 추정이 낮게 깔리는 이유
같은 편향 없는 신호 분산은 예측 가능 성분 비율(RPC, ratio of predictable components) 추정에도 쓰인다. RPC는 예측 가능한 신호와 개별 멤버 사이의 상관으로 다시 정의할 수 있고, 그러면 앙상블 크기에 불변인 추정량이 나온다. 이는 모델의 예측 가능성이 관측보다 얼마나 큰지를 재는 지표다.
논문은 이와 대조되는 분산 기반 RPC 추정치들이 체계적으로 낮게 편향된다고 지적한다. 그 편향은 오직 앙상블 크기와 모델의 신호 대 잡음비에만 의존하는 인자로 결정된다. 모델의 예측 가능 성분만 따로 보정하는 형태조차 이 낮은 편향을 피하지 못한다. 즉 "보정했으니 됐다"는 흔한 절차가 RPC에서는 여전히 아래쪽으로 치우친 값을 낸다.
논문이 스스로 인정한 한계
이 글은 단일 저자의 노트 형식 논문으로, 새로운 예보 기법을 제안하기보다 기존 추정량들의 거동을 정리하고 특성화하는 데 목적이 있다. 따라서 모델의 구조적 오차나 물리 과정의 결함은 다루지 않는다. 또한 멤버 교환 가능성이라는 가정이 깨지는 앙상블, 예컨대 멤버 간 의존성이 강한 구성에서는 출발점 자체가 흔들린다.
사례 수가 적을 때 신호 분산 추정의 불확실성이 커진다는 점도 남는다. 그래서 r∞가 범위를 벗어나는 일이 잦아지고, 그때 논문이 주는 답은 "값을 억지로 만들지 말라"는 쪽이다. 그렇다면 실무의 질문은 이렇게 바뀐다. 우리는 지금 멤버 수가 만든 성적표를 보고 있는가, 아니면 예보의 실제 실력을 보고 있는가. 최근 발표한 예보 검증에서 앙상블 크기를 바꿔 같은 지표를 다시 계산해 본 적이 있는가.
참고 자료
Christopher David Roberts, "Estimating ensemble-mean anomaly correlations and the ratio of predictable components using an unbiased estimate of the predictable signal variance", arXiv:2611.07878 (physics.ao-ph), 2026-11-05. https://arxiv.org/abs/2611.07878
이미지 출처: Wikimedia Commons — Environmental Modeling Center(NOAA/NWS), Public domain; Prof. Robert Fovell(UCLA)·Dr. Hui Su(JPL), Public domain.
댓글1
-
빗방울
2026.11.07 22:27
멤버 수 바꿨다고 r이 0.62에서 0.68로 점프하는 거 진짜 소름이다 ㅋㅋ 모델 탓인 줄 알았는데 그냥 표본 잡음이 신호 희석한 거였음. 신호 분산에서 잡음 기대분산 걷어내는 발상이 핵심인데, 근데 r이 1.2나 -1.3으로 튀어나올 때 계산 버그가 아니라 "이 데이터로는 못 답한다"는 증거라는 대목이 제일 셈. 우리도 검증 지표 돌릴 때 앙상블 크기 좀 바꿔서 재현해봐야겠다 ㄷㄷ
모든 이야기2313
가벼운 안부부터 깊은 생각까지, 함께 나눠요.
총 2313개의 이야기