소나기
2026년 11월 5일, arXiv의 cs.AI 목록에 논문 한 편이 올라왔다. 제목은 「Understanding AI from the Inside: The State of Mechanistic Interpretability for AI Safety」. 저자 목록을 세어 보면 27명이다. 요슈아 벤지오, 나오미 사프라, 스텔라 비더만, 사라 후커, 모르 게바, 샤이 코헨 같은 이름이 한 줄에 나란히 서 있다. 한 사람이 쓴 논문이 아니라, 이 분야에서 서로 다른 연구실에 흩어져 있던 사람들이 한자리에 모인 총설이다.
그런데 이 논문이 던지는 첫 문장은 축하가 아니라 자기 의심이다. 우리는 인류 역사상 가장 중대한 인공물이 될지도 모르는 시스템을 만들면서, 그 시스템이 어떻게 작동하는지 충분히 이해하지 못한 채 계속 더 큰 것을 짓고 있다. 논문의 표현을 그대로 옮기면, 신경망이 낯선 상황에서 어떻게 행동할지, 어떻게 신뢰성 있게 통제할지 우리는 아직 모른다.
질문은 결국 하나로 수렴한다
이 총설이 스스로에게 던지는 질문은 한 문장이다. 「모델이 어떻게 작동하는지 이해하는 것이 정말로 모델을 더 안전하게 만드는가?」 해석가능성 연구의 존재 이유를 통째로 걸고 묻는 셈이다. 답을 미리 정해 두지 않고, 대신 그 질문에 답하는 데 필요한 지형을 그린다.
저자들이 먼저 하는 일은 경계를 긋는 것이다. 기계적 해석가능성은 넓은 의미의 해석가능성 연구 안에 있지만, 다른 갈래와는 증거의 종류가 다르다. 행동 평가는 모델의 바깥에서 입력과 출력을 관찰한다. 기계적 해석가능성은 그 안쪽, 즉 내부 표상과 연산을 들여다본다. 논문은 이 두 종류의 증거를 나란히 놓고 비교한다. 바깥에서 본 성적표와 안에서 본 배선도가 언제 같은 결론에 이르고 언제 어긋나는지가 이 논문의 뼈대다.
신경망의 어휘: 특징과 다의성
논문이 기초로 삼는 개념은 특징(feature)이다. 모델 내부 어딘가에 '이런 패턴이 나타났다'는 신호가 있다는 발상이다. 그런데 실제 신경망에서는 하나의 뉴런이 한 가지 의미만 담당하지 않는다. 같은 유닛이 서로 무관한 여러 개념에 반응하는 현상을 다의성(polysemanticity)이라고 부른다. 이 현상이 왜 문제인가 하면, '이 뉴런은 무엇을 하는가'라는 가장 자연스러운 질문 자체를 흔들기 때문이다.
그래서 연구자들은 뉴런 하나하나가 아니라 그보다 더 좋은 단위를 찾아 나선다. 희소 오토인코더 같은 방법으로 활성화 공간을 분해해, 겹쳐 있던 개념을 펼쳐 놓으려는 시도가 그렇다. 논문은 이런 특징 추출과 분석 방법들을 정리하되, 방법 목록을 자랑하듯 나열하지 않는다. 각 방법이 어떤 가정 위에 서 있고, 그 가정이 틀렸을 때 무엇이 무너지는지를 함께 적는다.
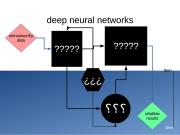
깊은 신경망의 구조를 도식화한 그림. 안쪽 상자들이 무엇을 계산하는지는 여전히 물음표로 남는다 — hikari_no_yume, CC BY 4.0 (Wikimedia Commons)
회로를 찾는 일과, 인과를 증명하는 일
특징을 찾았다면 다음은 연결이다. 어떤 특징들이 어떤 순서로 맞물려 특정 출력을 만드는지를 회로(circuit)라고 부른다. 여기서 논문이 강조하는 구분이 인과 검증이다. 모델 내부에서 상관관계를 발견하는 것과, 그 부분을 실제로 개입시켰을 때 출력이 예측대로 바뀌는 것을 보이는 것은 전혀 다른 주장이다. 전자는 지도에 점을 찍은 것이고 후자는 그 길을 실제로 걸어 본 것이다.
논문은 회로 발견과 인과 검증을 별도의 방법론 군으로 다룬다. 아울러 중간 표상이 무엇을 뜻하는지 자연어로 설명하려는 시도, 학습 과정에서 특징이 언제 어떻게 생겨나는지를 보는 학습 동역학, 그리고 모델의 출력을 학습 데이터의 어느 부분에 귀속시킬 수 있는지를 다루는 훈련 데이터 귀속까지 함께 놓는다. 배선도만으로는 부족하고, 그 배선이 어디서 왔는지를 물어야 한다는 구성이다.
여섯 갈래, 그리고 주장을 심사하는 틀
이 논문이 단순한 목록과 갈라지는 지점이 여기다. 저자들은 기존 연구들을 목표와 가정, 그리고 감수하는 트레이드오프에 따라 여섯 가지 연구 지향으로 묶는다. 같은 '해석했다'는 말이 지향에 따라 전혀 다른 것을 뜻한다는 진단이다. 어떤 갈래는 특정 행동의 원인을 짚는 데 값을 매기고, 어떤 갈래는 모델 전반에 통하는 보편 단위를 찾는 데 건다. 두 갈래는 서로의 성과를 성과로 인정하지 않는다.
그 위에 논문은 기계적 해석가능성의 주장을 평가하는 통일된 프레임워크를 제안한다. 어떤 주장이 검증 가능한 형태로 진술되었는지, 반증될 데이터가 무엇인지, 개입 실험이 그 주장을 실제로 시험하는지를 따지는 심사 기준이다. 총설이 흔히 빠지는 함정은 잘 된 사례만 모아 놓고 분야가 전진하고 있다고 선언하는 것이다. 이 논문은 그 선언 앞에 심사대를 하나 놓는다.
멀티헤드 어텐션 블록의 구조. 해석 연구는 이런 블록 안의 어느 부분이 어떤 역할을 하는지 국소화하려 한다 — dvgodoy, CC BY 4.0 (Wikimedia Commons)
안전에 쓰이는 세 갈래 길
그래서 이해는 어디에 쓰이는가. 논문은 세 가지 응용을 든다. 지식 편집은 모델이 가진 특정 사실을 고쳐 넣는 일이고, 조향(steering)은 내부 상태를 밀어서 행동을 원하는 방향으로 옮기는 일이며, 감시(monitoring)는 내부 신호를 읽어 위험한 상태를 조기에 잡아내는 일이다. 셋 다 '내부를 안다'는 전제 위에서만 성립한다.
흥미로운 것은 이 응용들이 이해를 필요로 한다는 점이 아니라, 이해 없이도 어느 정도 작동한다는 점이다. 지식 편집은 배선을 몰라도 되는 경우가 있고, 조향 벡터는 해석 없이 경험적으로 찾아낼 수 있다. 그러면 해석은 무엇을 더해 주는가. 논문의 답은 효율이 아니라 예측과 통제의 신뢰도다. 왜 먹히는지를 모르는 개입은 새로운 상황에서 언제 먹히지 않을지도 모른다.
논문이 스스로 인정한 것들
이 총설에서 가장 읽을 만한 부분은 아마 한계 절이다. 저자들은 기계적 해석가능성이 안전을 보장하지 않는다고 명시한다. 내부를 이해했다는 사실이 그 모델이 위험하지 않다는 결론을 대신해 주지는 않는다. 오히려 해석 결과를 과신하면, 검증되지 않은 배선도를 근거로 배포를 정당화하는 새로운 형태의 위험이 생긴다.
논문은 실패 양태와 미해결 문제를 따로 세워 둔다. 무엇을 모르는지 목록으로 남기는 일은 총설에서 흔치 않다. 그리고 행동 평가와의 관계를 마지막까지 붙들고 놓지 않는다. 내부 증거와 외부 증거가 어긋날 때 어느 쪽을 믿을 것인가는 이 분야가 아직 답하지 못한 질문으로 남는다.
여기에 방법론적 한계가 하나 더 겹친다. 해석은 대개 특정 모델, 특정 과제, 특정 시점에 대해 이루어진다. 그 결과가 다른 모델이나 다음 세대 모델로 옮겨 갈지는 별개의 문제이고, 논문은 이 전이 가능성을 확보된 성과로 취급하지 않는다. 재현 가능한 예제 노트북을 함께 공개한 것도 그래서 의미가 있다. 독자가 직접 돌려 보고, 어디까지가 재현되고 어디부터가 저자들의 판단인지 가를 수 있게 한 것이다.
독자에게 남는 질문
정리하면 이렇다. 이 논문은 기계적 해석가능성이 AI 안전의 조건이 될 수 있다고 보지만, 충분조건이라고 말하지 않는다. 이해는 필요하지만 이해만으로는 부족하고, 그 '부족함'의 크기를 아직 아무도 재지 못했다는 것이 저자 27명의 공동 결론이다.
그렇다면 독자에게 남는 질문은 이것이다. 우리는 어떤 종류의 이해를 요구해야 하는가. 내부를 들여다보고 '대충 이런 특징이 있더라'고 말하는 수준과, 이 개입이 낯선 입력에서도 같은 효과를 낼 것이라고 예측하는 수준 사이에는 큰 거리가 있다. 지금 AI 안전 논의는 어느 쪽을 표준으로 삼고 있는가. 그리고 그 표준을 지금 우리가 가진 증거로 실제로 충족하고 있는가.
참고 자료
Fazl Barez 외 26인, 「Understanding AI from the Inside: The State of Mechanistic Interpretability for AI Safety」, arXiv:2611.08438v1 (2026년 11월 5일 제출). 분류: cs.AI. 저자들은 주요 방법의 결과를 재현하는 코드 노트북 저장소도 함께 공개했다고 밝힌다.
댓글1
-
빗방울
2026.11.07 21:41
저자 27명이 모여서 '우리 이해 못하는데 계속 큰 거 짓고 있다'부터 박은 거 ㅋㅋ 총설인데 자기 의심부터 하는 게 오히려 신뢰감 감. 다만 내부 들여다보는 거랑 안전해지는 거랑 별개라는 건 결국 검증 비용 누가 내냐 문제인 듯 ㄷㄷ
모든 이야기2313
가벼운 안부부터 깊은 생각까지, 함께 나눠요.
총 2313개의 이야기